「HPCエンジニア」という職種名を求人で見かけて、具体的に何をするのか分からなかった方は多いと思います。
調べても出てくるのは、メーカーの製品紹介か、大学の利用マニュアルばかりです。実務の中身を書いた日本語の記事は、ほとんど存在しません。
この記事では、HPCエンジニアが日々何をしているのかを、一般的なインフラエンジニアとの違いに絞って説明します。インフラ運用の経験がある方が、自分の経験のどこが通用してどこが新しいのかを判断できる状態をゴールにします。
HPCエンジニアとは
HPC は High Performance Computing(高性能計算)の略です。HPCエンジニアは、大量の計算を高速に処理するための計算基盤を、設計・構築・運用する技術者を指します。
対象になるのは次のようなシステムです。
- 国立研究所・大学の情報基盤センターのスーパーコンピュータ
- 製造業の解析用計算クラスタ(流体解析、構造解析、衝突シミュレーション)
- 製薬・素材メーカーの分子シミュレーション環境
- 気象・防災機関の数値予報システム
- AI/機械学習向けのGPUクラスタ
いずれも実体は Linuxクラスタです。ラックに並んだ多数のサーバを高速ネットワークでつなぎ、1つの計算資源として束ねたものです。
近年はAI・機械学習の普及で、GPUクラスタを扱う求人が「AI/HPCインフラエンジニア」という名前で出ることも増えました。扱う技術の土台は従来のHPCと同じです。
運用の全体像については、スーパーコンピュータの運用管理とは|Linuxエンジニアの仕事 で詳しく書いています。
一般的なインフラエンジニアとの違い
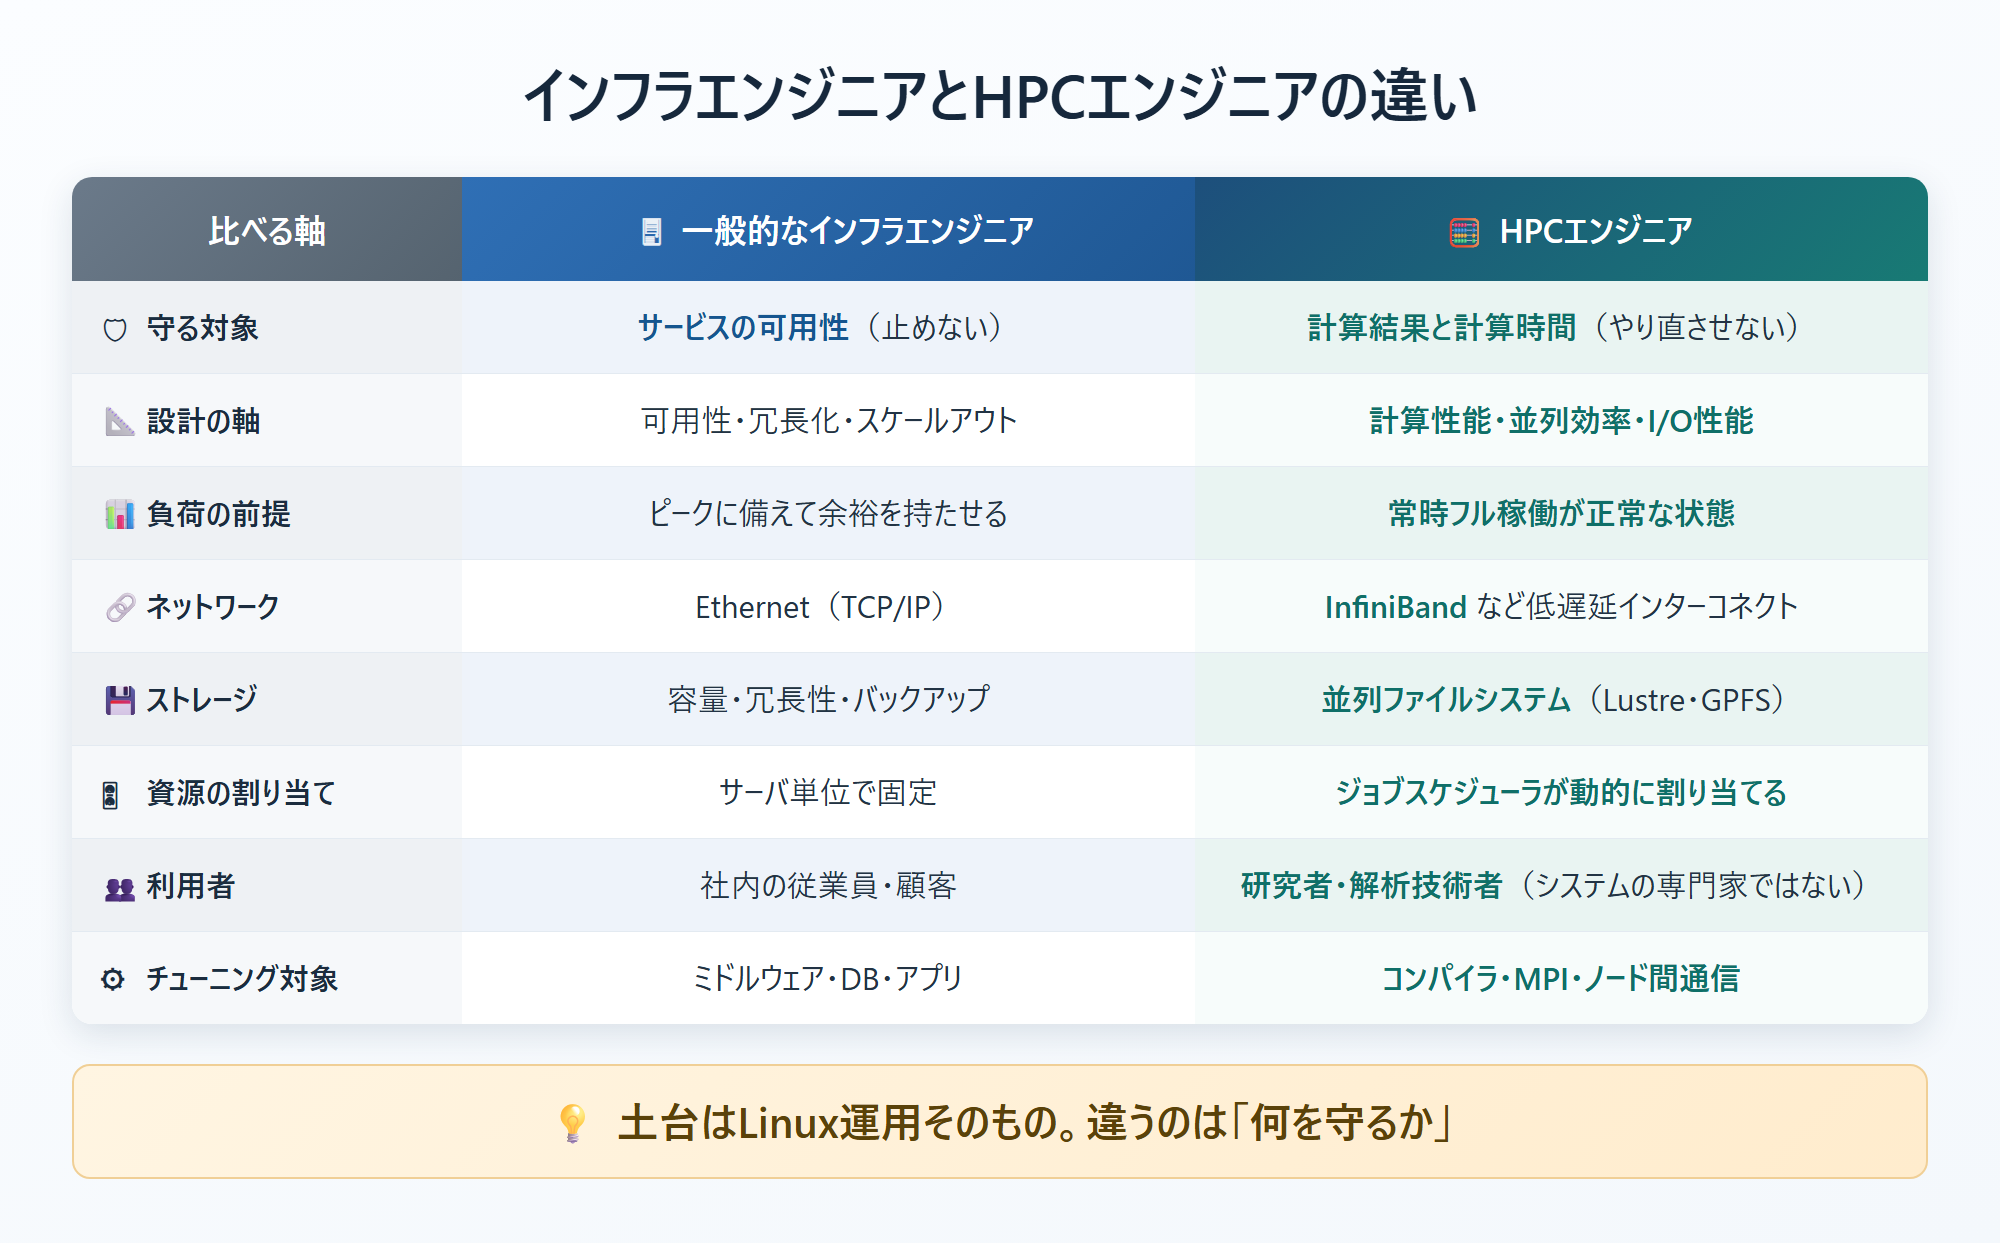
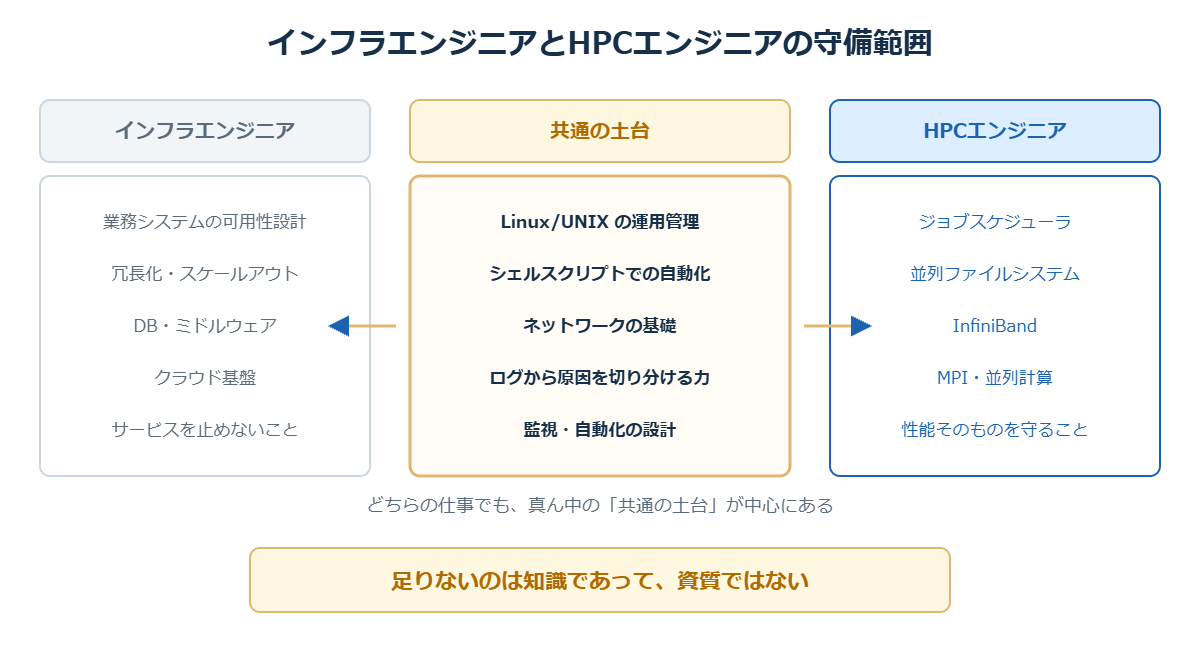
重なる部分は非常に多く、土台はLinux運用そのものです。そのうえで、違いが出るのは次の点です。
| 一般的なインフラエンジニア | HPCエンジニア | |
|---|---|---|
| 守る対象 | サービスの可用性(止めない) | 計算結果と計算時間(やり直させない) |
| 設計の軸 | 可用性・冗長化・スケールアウト | 計算性能・並列効率・I/Oスループット |
| 負荷の前提 | ピークに備えて余裕を持たせる | 常時フル稼働が正常な状態 |
| ネットワーク | Ethernet(TCP/IP) | InfiniBand など低遅延インターコネクト |
| ストレージ | 容量・冗長性・バックアップ | 並列ファイルシステム(Lustre、GPFS、BeeGFS) |
| 資源の割り当て | サーバ単位で固定 | ジョブスケジューラが動的に割り当てる |
| 利用者 | 社内の従業員・顧客 | 研究者・解析技術者(システムの専門家ではない) |
| チューニングの対象 | ミドルウェア・DB・アプリ | コンパイラオプション、MPI、ノード間通信 |
違いが最も出るのは「性能」の扱い
一般的なインフラ運用で性能が問題になるのは、遅くてサービスに支障が出たときです。平常時は、多少の余裕があるほうが安全とされます。
HPCでは逆で、性能そのものが成果物です。
計算が10%速くなれば、同じ予算で10%多くの研究ができます。ノードが1台遊んでいれば、その分の投資が無駄になっています。「動いているが遅い」は、HPCでは立派な障害として扱われます。
この価値観の違いが、業務の中身を大きく分けています。
「遅い」が障害になるとはどういうことか
分かりやすいのが、ノード単体は正常なのに、複数ノードを使った計算だけが遅くなるというケースです。
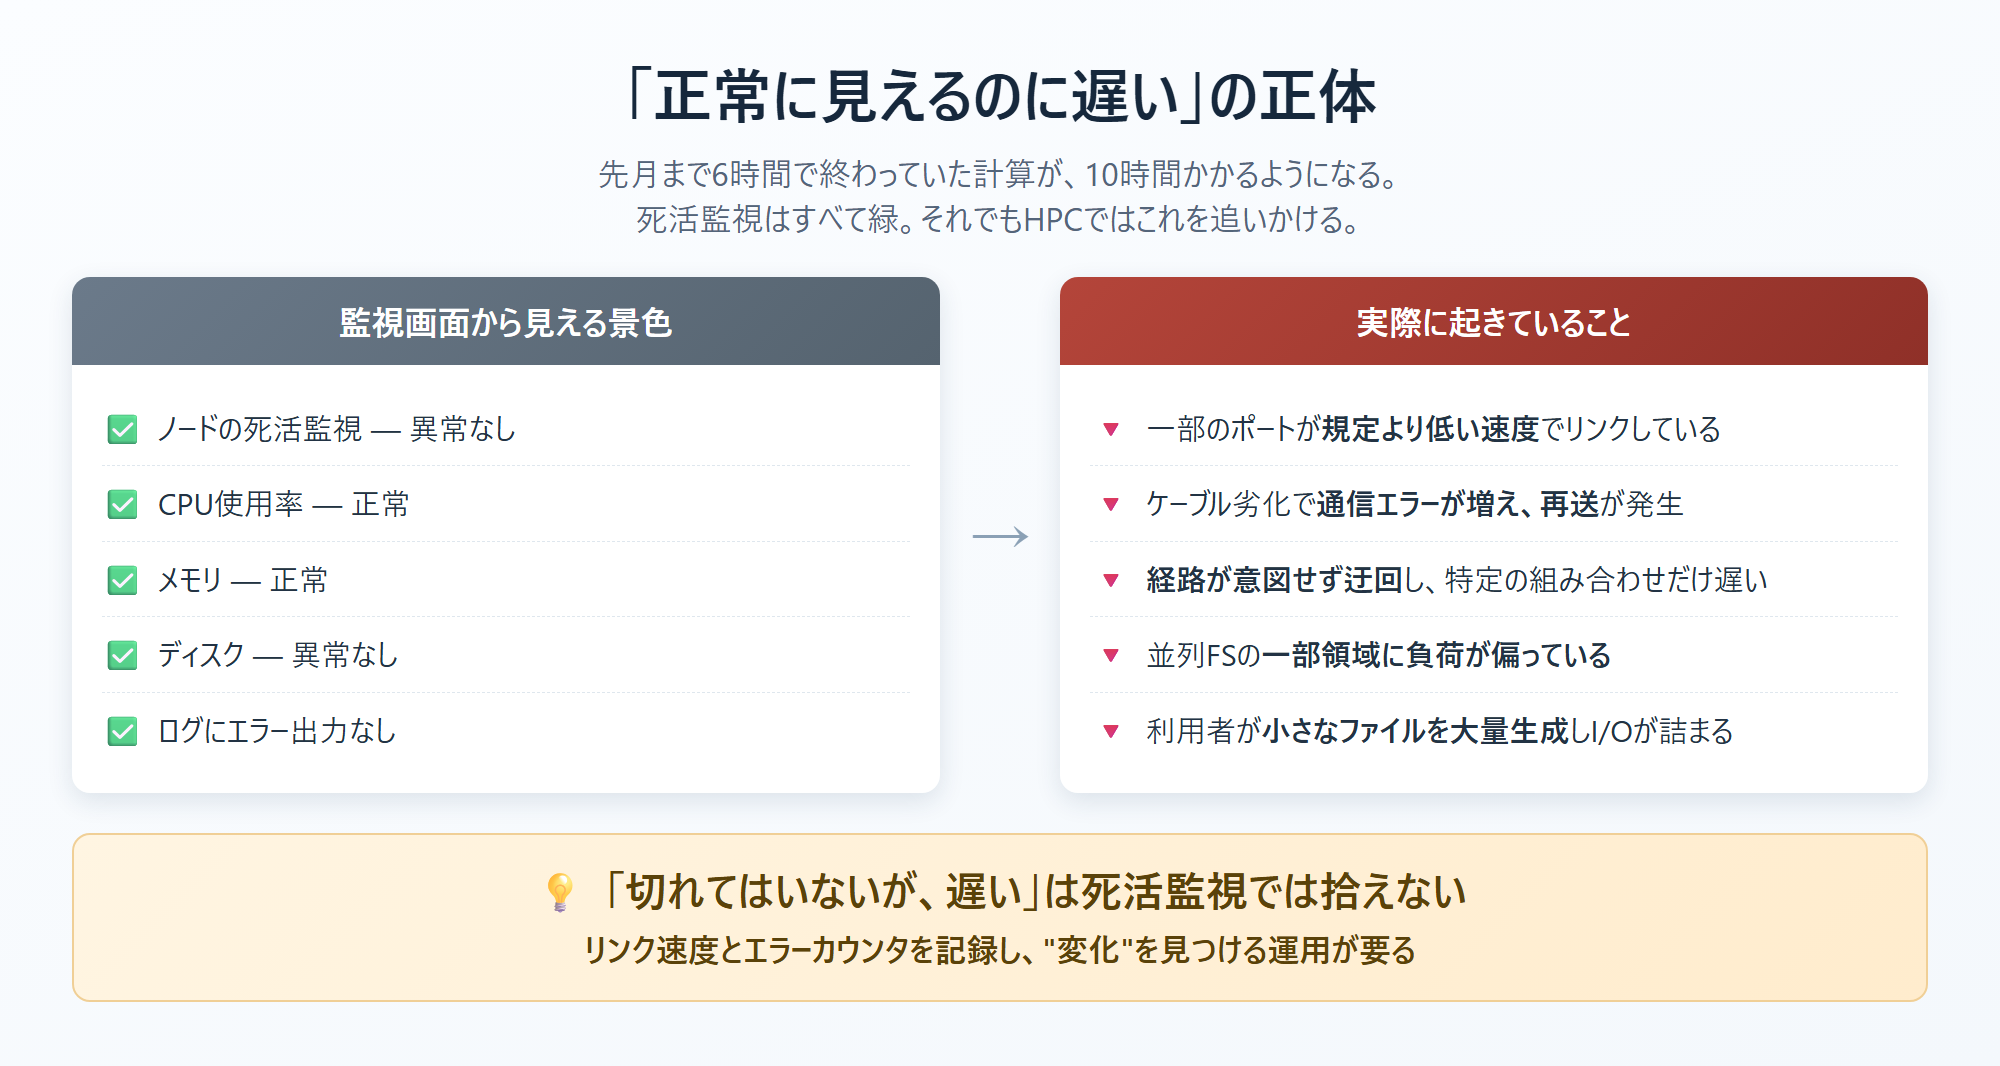
死活監視はすべて緑、CPU使用率も正常、ディスクにも異常なし。それでも、先月まで6時間で終わっていた計算が10時間かかるようになる。一般的なサーバ運用の感覚では「障害」として扱われない状態ですが、HPCではこれを追いかけます。
典型的な原因は、ノードとノードをつなぐインターコネクトにあります。
- 一部のポートが、規定より低い速度でリンクしてしまっている
- ケーブルやトランシーバの劣化で、通信エラーが増えて再送が発生している
- 経路が意図せず迂回していて、特定のノードの組み合わせだけ遅い
いずれも「切れてはいないが、遅い」という状態です。死活監視では拾えません。リンク速度とエラーカウンタを継続的に記録しておき、変化を見つける運用が要ります。
原因がストレージ側にあることもあります。並列ファイルシステムの一部の領域に負荷が偏っていたり、利用者が「小さなファイルを大量に作る」処理を始めたりすると、全体のI/Oが詰まります。
こうした「正常に見えるのに遅い」の切り分けが、HPCエンジニアの腕の見せどころです。
違いが出にくいのは「日々の手触り」
一方で、実際の作業の手触りは驚くほど普通です。
- OSは Linux(RHEL系、Rocky Linux、Ubuntu など)
- 接続は ssh、操作はコマンドライン
- 設定はテキストファイル、管理はGitやAnsible
- 自動化は Bash と Python
- 監視は Zabbix、Prometheus、Nagios などの一般的なツール
ログを読んで原因を切り分けるという仕事の本質は、まったく同じです。
仕事内容を工程ごとに見る
HPCエンジニアの求人は、担当する工程によって中身がかなり変わります。応募前にここを確認しておくと、ミスマッチを避けられます。
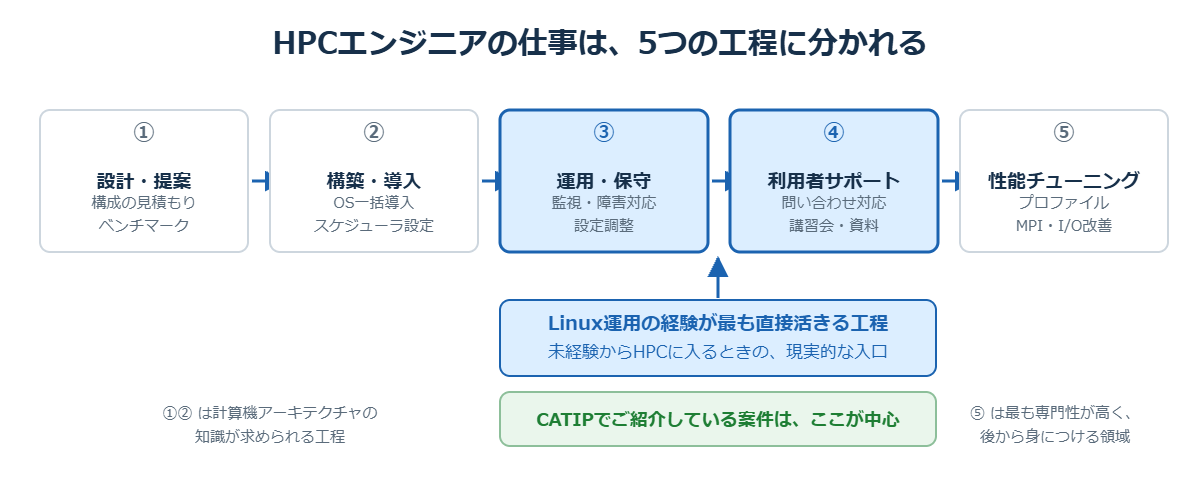
① 設計・提案
顧客の計算内容を聞き、必要なノード数・CPU/GPU構成・メモリ容量・ネットワーク構成・ストレージ性能を見積もります。
- ベンチマークの実施と結果の評価
- 電力・冷却・ラックスペースの制約との調整
- 予算内での構成の最適化
メーカーやSIerのポジションに多い工程です。計算機アーキテクチャの知識が要求されます。
② 構築・導入
設計された構成を、実際に動く計算基盤として立ち上げます。
- OSとドライバの一括インストール(キッティングの自動化)
- ジョブスケジューラの導入とパーティション設計
- 並列ファイルシステムの構築
- コンパイラ・MPI・科学技術計算ライブラリの導入
- 性能測定と受け入れ試験
数百台を手作業では扱えないため、自動化スクリプトを書ける人が重宝されます。
③ 運用・保守 ← Linux運用経験が最も直接活きる工程
稼働中のシステムを正常な状態に保ちます。
- 計算ノードの死活監視・ハードウェア障害の検知
- 異常ノードのスケジューラからの切り離し
- ジョブが落ちた原因の切り分け(ハード/ネットワーク/利用者プログラム)
- ジョブスケジューラの設定調整、待ち行列の監視
- セキュリティパッチの適用計画とメンテナンス調整
- バックアップとリカバリ
未経験からHPCに入る場合、現実的な入口はこの工程です。 必要なスキルの大半がLinux運用と共通しているためです。
④ 利用者サポート
比重の大きい業務です。利用者は計算の専門家であっても、システムの専門家ではありません。
- 利用申請・アカウント発行・利用資源量の管理
- ジョブの書き方、モジュールの読み込み方、コンパイル方法の問い合わせ対応
- 講習会・マニュアルの整備
技術力よりも、相手の状況を聞き出して何が起きているかを翻訳する力が要ります。
⑤ 性能チューニング
計算が想定より遅いとき、原因を特定して改善します。
- プロファイラによるボトルネックの特定
- コンパイラオプション・MPI実装の見直し
- ノード間通信パターンの改善
- I/Oパターンの改善
最も専門性が高い領域です。ここは後から身につける部分と考えて構いません。
CATIPでご紹介している案件はどこを担当するか
③運用・保守と④利用者サポートが中心です。具体的には次のような内容になります。
- Linuxサーバの構築、設定、および運用管理
- システムパフォーマンスの監視およびチューニング
- セキュリティ対策の実施(アクセス制御、ファイアウォール設定、ログ監視など)
- 障害対応およびトラブルシューティング
- システムアップデートおよびパッチ適用の計画・実施
- バックアップおよびリカバリープロセスの管理
- スクリプト作成による業務自動化(Bash、Python、Perlなど)
- ユーザーサポートおよび技術的な問い合わせ対応
- ドキュメント作成および運用手順の整備
上記をすべて担当するわけではありません。 案件ごとに内容が異なり、オファー時に仕事の中身をご提示したうえで、受けるかどうかを選んでいただけます。受けない場合の不利益はありません。
必要なスキルと、通用する経験
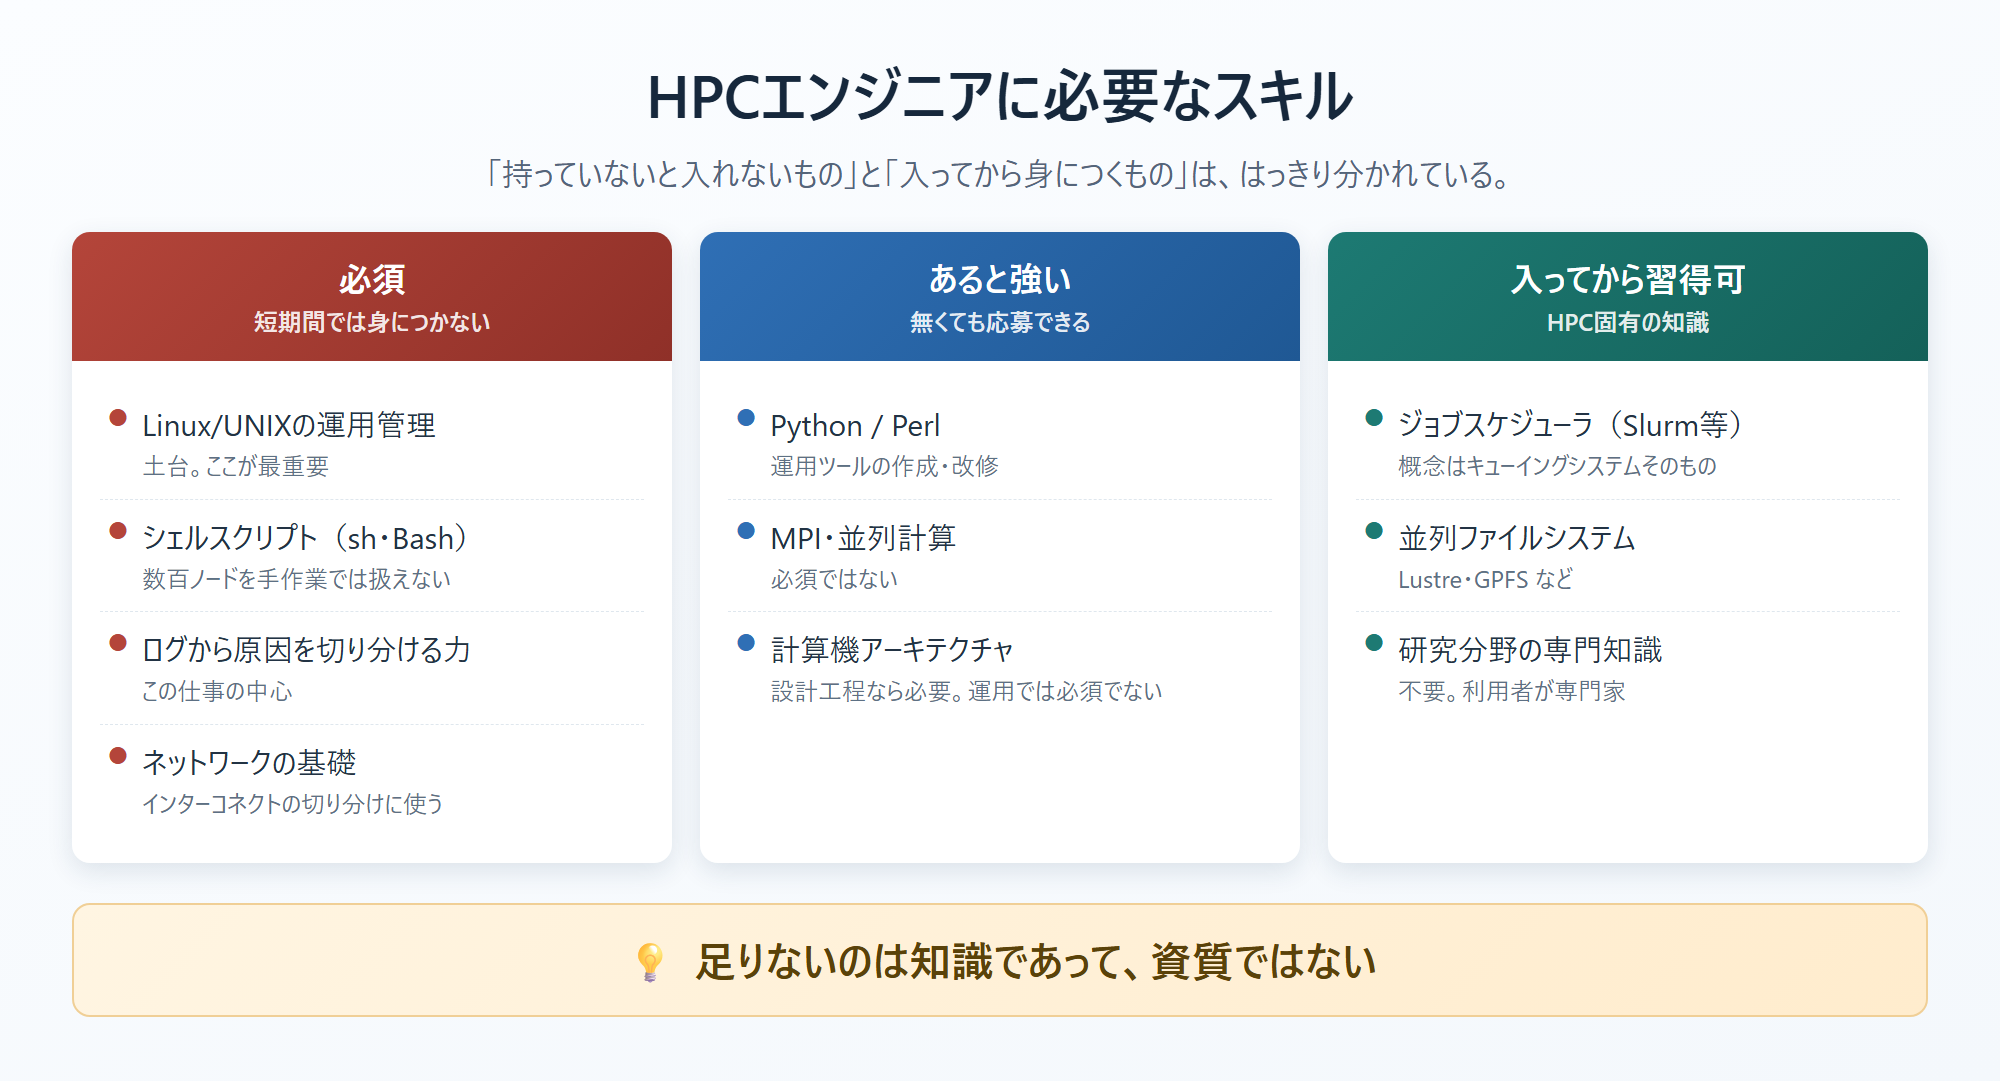
| スキル | 重要度 | 補足 |
|---|---|---|
| Linux/UNIXの運用管理 | 必須 | 土台。ここが最重要 |
| シェルスクリプト(sh、Bash) | 必須 | 数百ノードを手作業では扱えない |
| ログから原因を切り分ける力 | 必須 | この仕事の中心 |
| ネットワークの基礎 | 必須 | インターコネクトの切り分けに使う |
| Python / Perl | 推奨 | 運用ツールの作成・改修 |
| ジョブスケジューラ(Slurm等) | 入ってから習得可 | 概念はキューイングシステムそのもの |
| 並列ファイルシステム | 入ってから習得可 | Lustre、GPFS など |
| MPI・並列計算 | あると強い | 必須ではない |
| 計算機アーキテクチャ | 設計工程なら必要 | 運用工程では必須ではない |
| 研究分野の専門知識 | 不要 | 利用者が専門家 |
HPC固有の知識は、入ってから身につくものがほとんどです。逆に、Linuxの運用経験とログを追う力は、短期間では身につきません。すでにお持ちの経験がそのまま効く領域です。
ジョブスケジューラについては、Slurm入門|sbatch・squeue・sinfoの基本と運用の勘所 で基本をまとめています。実際に触る前に読んでおくと、面接でも話がしやすくなります。
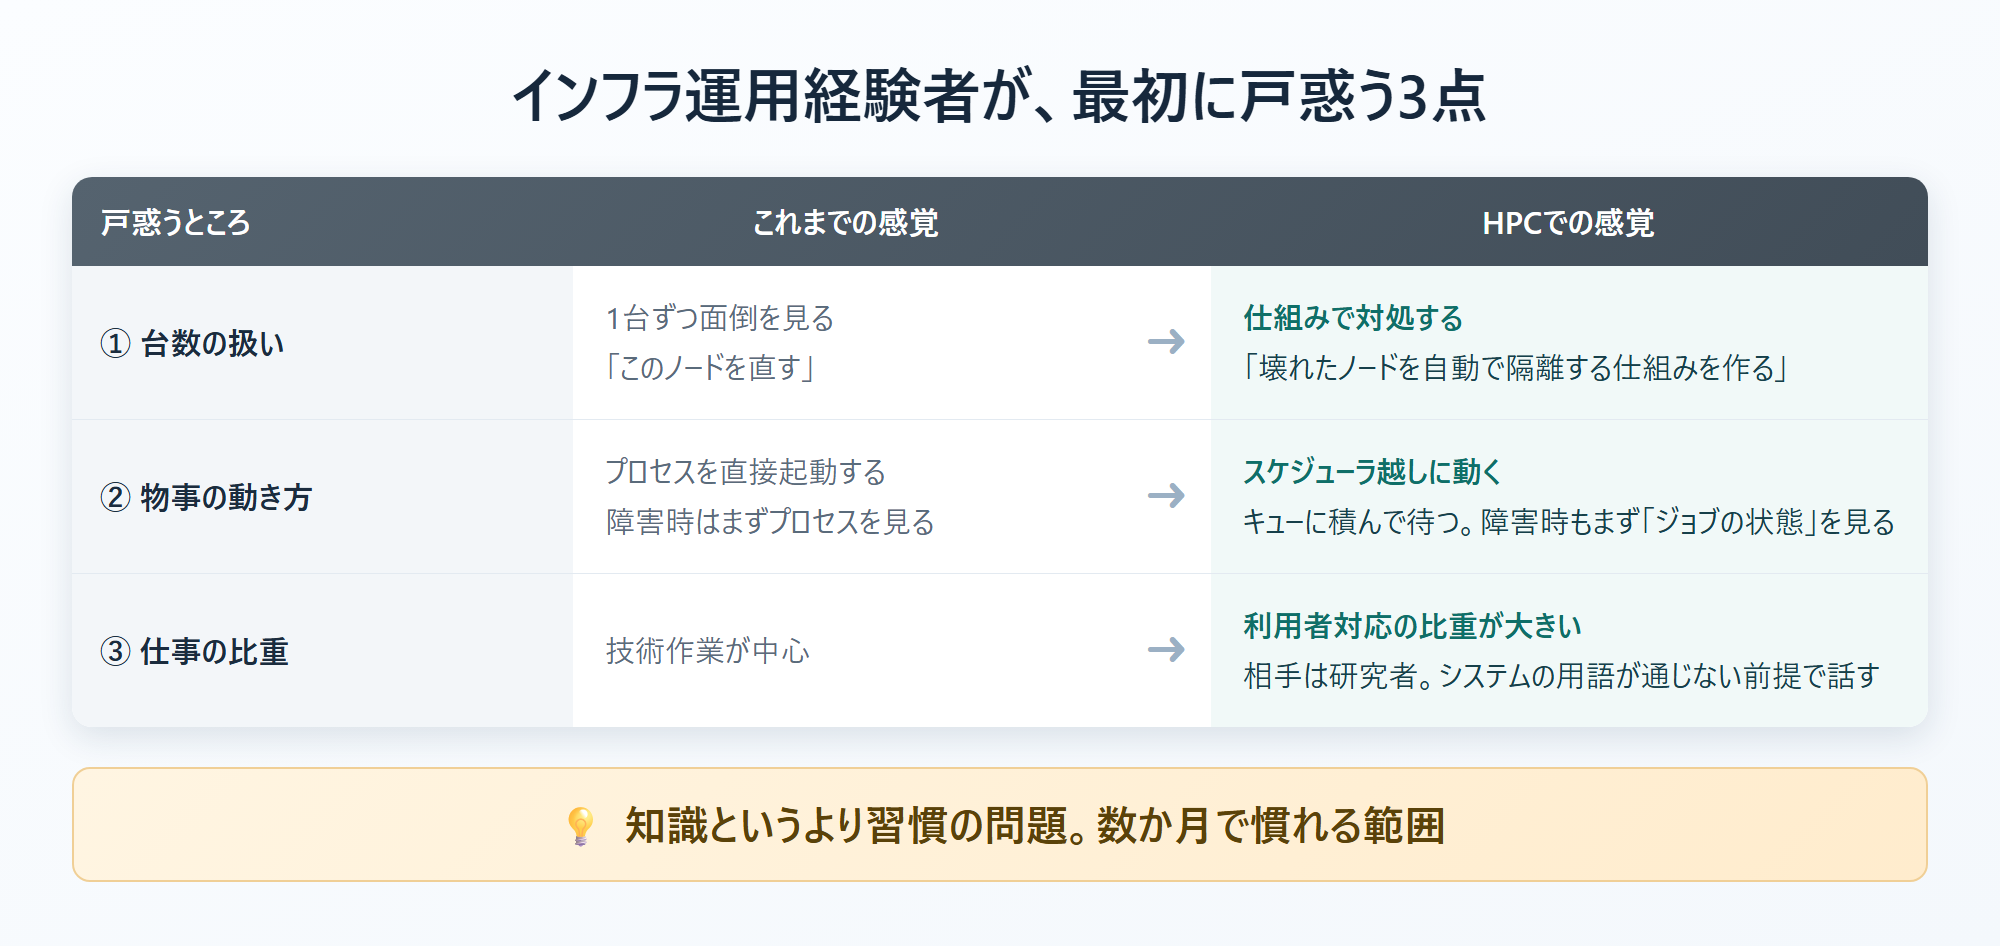
最初に戸惑いやすいところ
一般的なインフラ運用の経験がある方が、HPCで感覚の切り替えを求められるのは、だいたい次の3点です。
- 1台ずつ面倒を見ない — 数百台が相手なので、「このノードを直す」より「壊れたノードを自動で隔離する仕組みを作る」という発想に変わります
- スケジューラ越しに物事が動く — プロセスを直接起動せず、キューに積んで待つ。トラブル時も「プロセスを見る」前に「ジョブの状態を見る」のが先になります
- 利用者対応の比重が大きい — 技術作業だけの仕事ではありません。相手は研究者で、システムの用語が通じない前提で話す必要があります
いずれも知識というより習慣の問題で、数か月で慣れる範囲です。
よくある質問
インフラエンジニアからHPCに移れますか?
運用工程であれば、十分に移れます。 必要なスキルの大半が共通しているためです。不足するのはジョブスケジューラと並列ファイルシステムの知識ですが、どちらも概念自体は既存の技術の延長で、実務の中で習得できます。
設計・チューニング工程は計算機アーキテクチャや並列計算の知識が必要なため、まず運用から入るのが現実的です。
大学や研究機関の職員にならないと関われませんか?
いいえ。HPCの運用は、外部の技術者が受託して担っているケースが多いのが実情です。メーカー、SIer、運用受託事業者、業務委託と、関わり方は複数あります。所属が研究機関である必要はありません。
リモートで成立する仕事ですか?
運用・保守と利用者サポートは、リモートで成立します。 sshで接続できれば作業の大半が完結するためです。一方、ハードウェアの物理交換や初期構築時のラック作業は現地が必要です。求人を見るときは、どの工程を担当するのかを確認してください。
CATIPがご紹介している案件は、全国どこからでも在宅で勤務できるフルリモートです。勤務する曜日と時間帯はご自身で選べて、土日祝はお休み。時給3,000円〜で、直接雇用契約と業務委託契約を選べます。
年齢やブランクは不利になりますか?
HPCの運用は、考え方が長く変わらない領域です。ツールの名前は変わっても、ログを読んで切り分けるという本質は20年前と同じです。ブランクの長さより、現場で切り分けをしてきた量のほうが効きます。
まとめ
HPCエンジニアの仕事内容は、一般的なインフラエンジニアと土台を共有しつつ、価値観が違う仕事です。
- 実体は大規模なLinuxクラスタ。OS・コマンド・自動化の手触りは同じ
- 守るのは可用性ではなく、計算結果と計算時間
- 「動いているが遅い」が障害として扱われる
- 工程は①設計 ②構築 ③運用 ④利用者サポート ⑤チューニングの5つ。入口は③
- HPC固有の知識は入ってから習得できる。 Linux運用経験とログを追う力が土台
一般的なインフラ運用の経験をお持ちなら、その経験の多くはそのまま通用します。足りないのは知識であって、資質ではありません。
参考にした情報
- 「AI/HPCインフラエンジニア」という職種区分で求人が出ていること — プロメテックグループ 求人
- インフラエンジニアの業務範囲(サーバー・ネットワーク・ストレージ・OS・セキュリティ・クラウド、要件定義〜運用保守の4工程) — マイナビエージェント インフラエンジニアとは
- Slurm によるジョブ投入とノード/パーティション管理の仕組み — 理化学研究所 R-CCS Slurmドキュメント / Lawrence Berkeley National Laboratory Slurm Overview
この記事について
この記事は、株式会社計算科学 高度情報人材支援センター(CATIP)HPCエンジニアチームが執筆・監修しています。執筆体制と記事作成のポリシーは 執筆・監修者について をご覧ください。
Linux/UNIX の運用経験を、在宅で活かしませんか
この記事を公開している CATIP(高度情報人材支援センター) では、Linux/UNIXサーバの運用管理のご経験がある方に、お仕事をご紹介しています。
全国どこからでも在宅で、勤務する曜日も時間もご自身で選べます。
- フルリモート(全国47都道府県から応募できます)
- 勤務日・勤務時間は自由選択。土日祝はお休み
- 時給 3,000円〜
- 直接雇用契約と業務委託契約を選べます(派遣ではありません)
- 50代・60代の方、ブランクのある方も歓迎しています
「もう現場から離れている」「フルタイムは難しい」という方こそ、一度ご覧ください。オファー時に仕事の内容をご提示したうえで、受けるかどうかを選んでいただけます。受けない場合の不利益はありません。