スーパーコンピュータの運用管理、と聞くと特別な世界の話に聞こえるかもしれません。しかし実際に日々行われているのは、Linuxサーバの運用管理の延長線上にある仕事です。
この記事では、スパコンの運用管理がどんな仕事なのか、一般的なサーバ運用と何が違うのかを、業務の中身に沿って説明します。Linux/UNIXの運用経験がある方なら、「思ったより地続きだ」と感じていただけるはずです。
スーパーコンピュータの運用管理とは
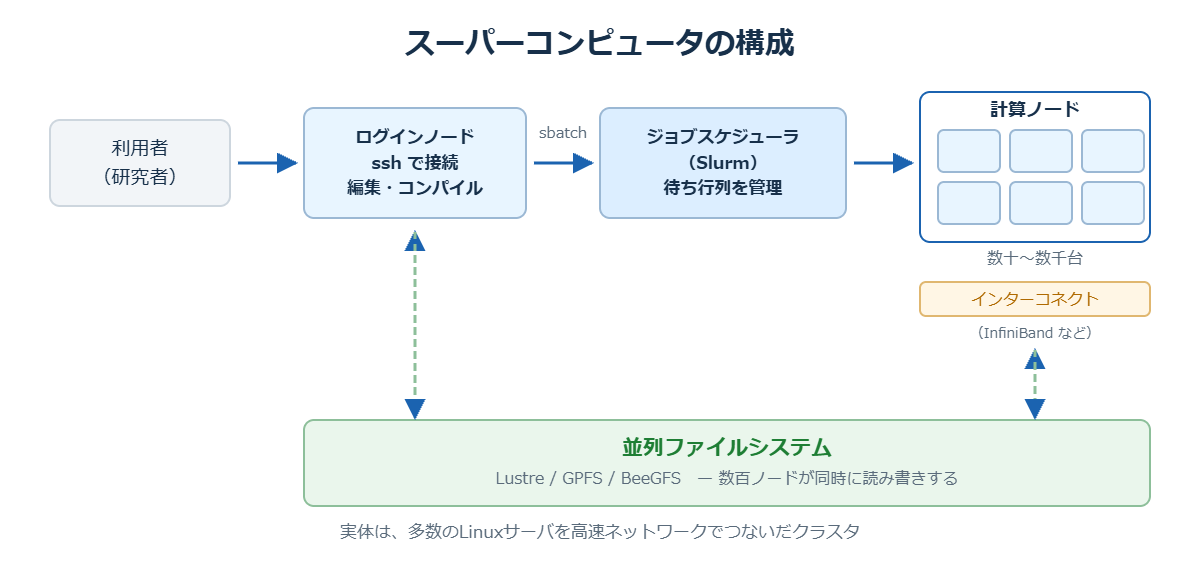
スーパーコンピュータは、大量の計算ノードをネットワークでつないだLinuxクラスタです。1台の特別な機械があるわけではなく、ラックに並んだ多数のサーバが協調して動いています。
そのため運用管理の実務も、OSはLinux、設定はテキストファイル、操作はssh経由のコマンドライン、という見慣れた形で行われます。
一方で、使われ方には大きな特徴があります。
- 利用者が直接サーバを触らない — 利用者は計算の内容を「ジョブ」として投入し、スケジューラが空いている計算ノードに割り当てる
- 常にフル稼働が前提 — 計算資源が余っている状態は「もったいない」とされ、混雑しているのが通常
- 1つのジョブが数日〜数週間動く — 途中で落ちると、それまでの計算がすべて無駄になる
- 利用者が研究者 — システム管理の専門家ではない人が、高度な計算をしている
この「使われ方の違い」が、運用管理の中身を一般的なサーバ運用と分けています。
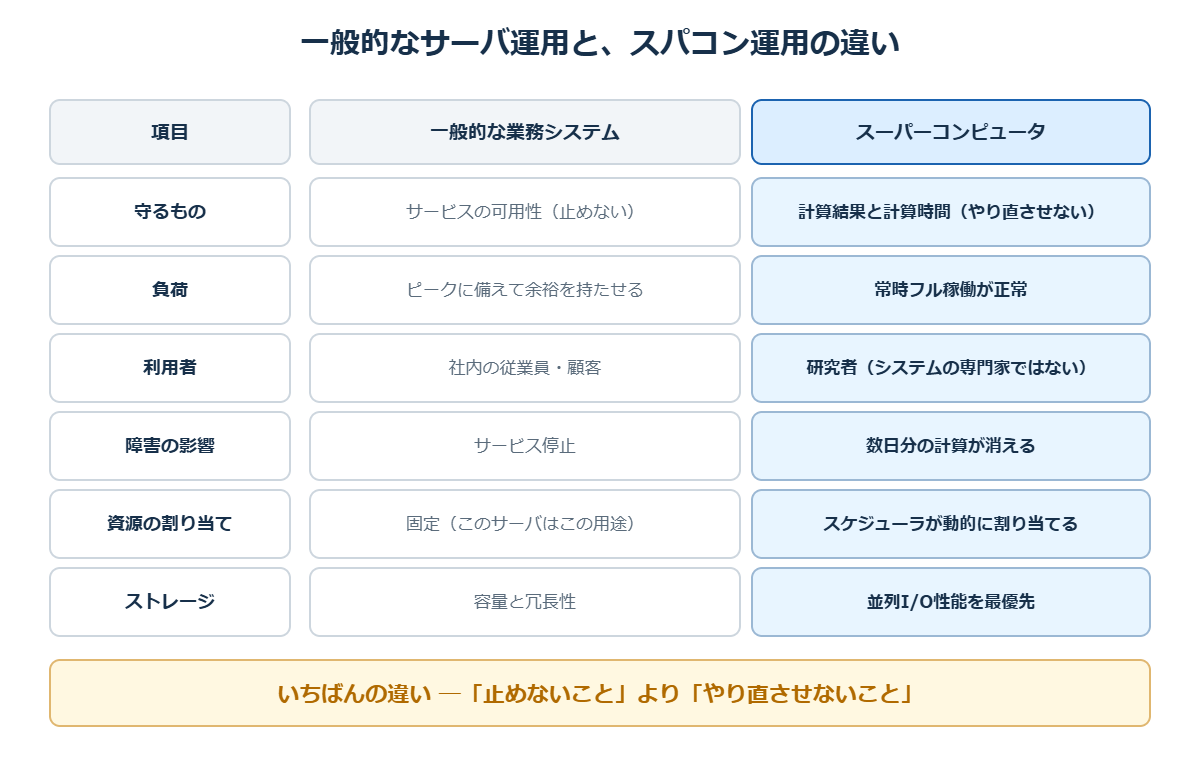
一般的なLinuxサーバの運用と何が違うのか
| 一般的な業務システム | スーパーコンピュータ | |
|---|---|---|
| 守るもの | サービスの可用性(止めない) | 計算結果と計算時間(やり直させない) |
| 負荷 | ピークに備えて余裕を持たせる | 常時フル稼働が正常 |
| 利用者 | 社内の従業員・顧客 | 研究者(システムの専門家ではない) |
| 障害の影響 | サービス停止 | 数日分の計算が消える |
| 資源の割り当て | 固定(このサーバはこの用途) | ジョブスケジューラが動的に割り当てる |
| ストレージ | 容量と冗長性 | 並列I/O性能(数百ノードが同時に読み書きする) |
いちばん大きな違いは、「止めないこと」より「やり直させないこと」が重視される点です。
たとえば1週間動き続けているジョブがあるとき、計算ノードを再起動する判断は慎重になります。利用者の1週間を消すことになるからです。
メンテナンスをいつ入れるかの判断
この「落とすか、待つか」の判断には、おおむね次の材料が使われます。
- 残りの実行予定時間 — ジョブには最大実行時間が指定されているため、あと何時間で終わる可能性があるかが分かる
- チェックポイントの有無 — 途中状態を保存しながら動くジョブなら、落としても再開できる。保存していないジョブは最初からやり直しになる
- 緊急度 — ハードウェア故障が進行中なら、待っているあいだにどのみち落ちる
- 利用者との調整余地 — 連絡が取れるなら、本人に判断してもらうのが最も確実
計画メンテナンスの場合は、実行時間の上限を一時的に短くして、メンテ日時をまたぐジョブが投入されないようにするのが定石です。当日に慌てて止めるのではなく、数日前から新規ジョブの入り口を絞っていくわけです。
こうした段取りの組み立てが、通常のサーバ運用以上に重要になります。
運用管理の具体的な業務
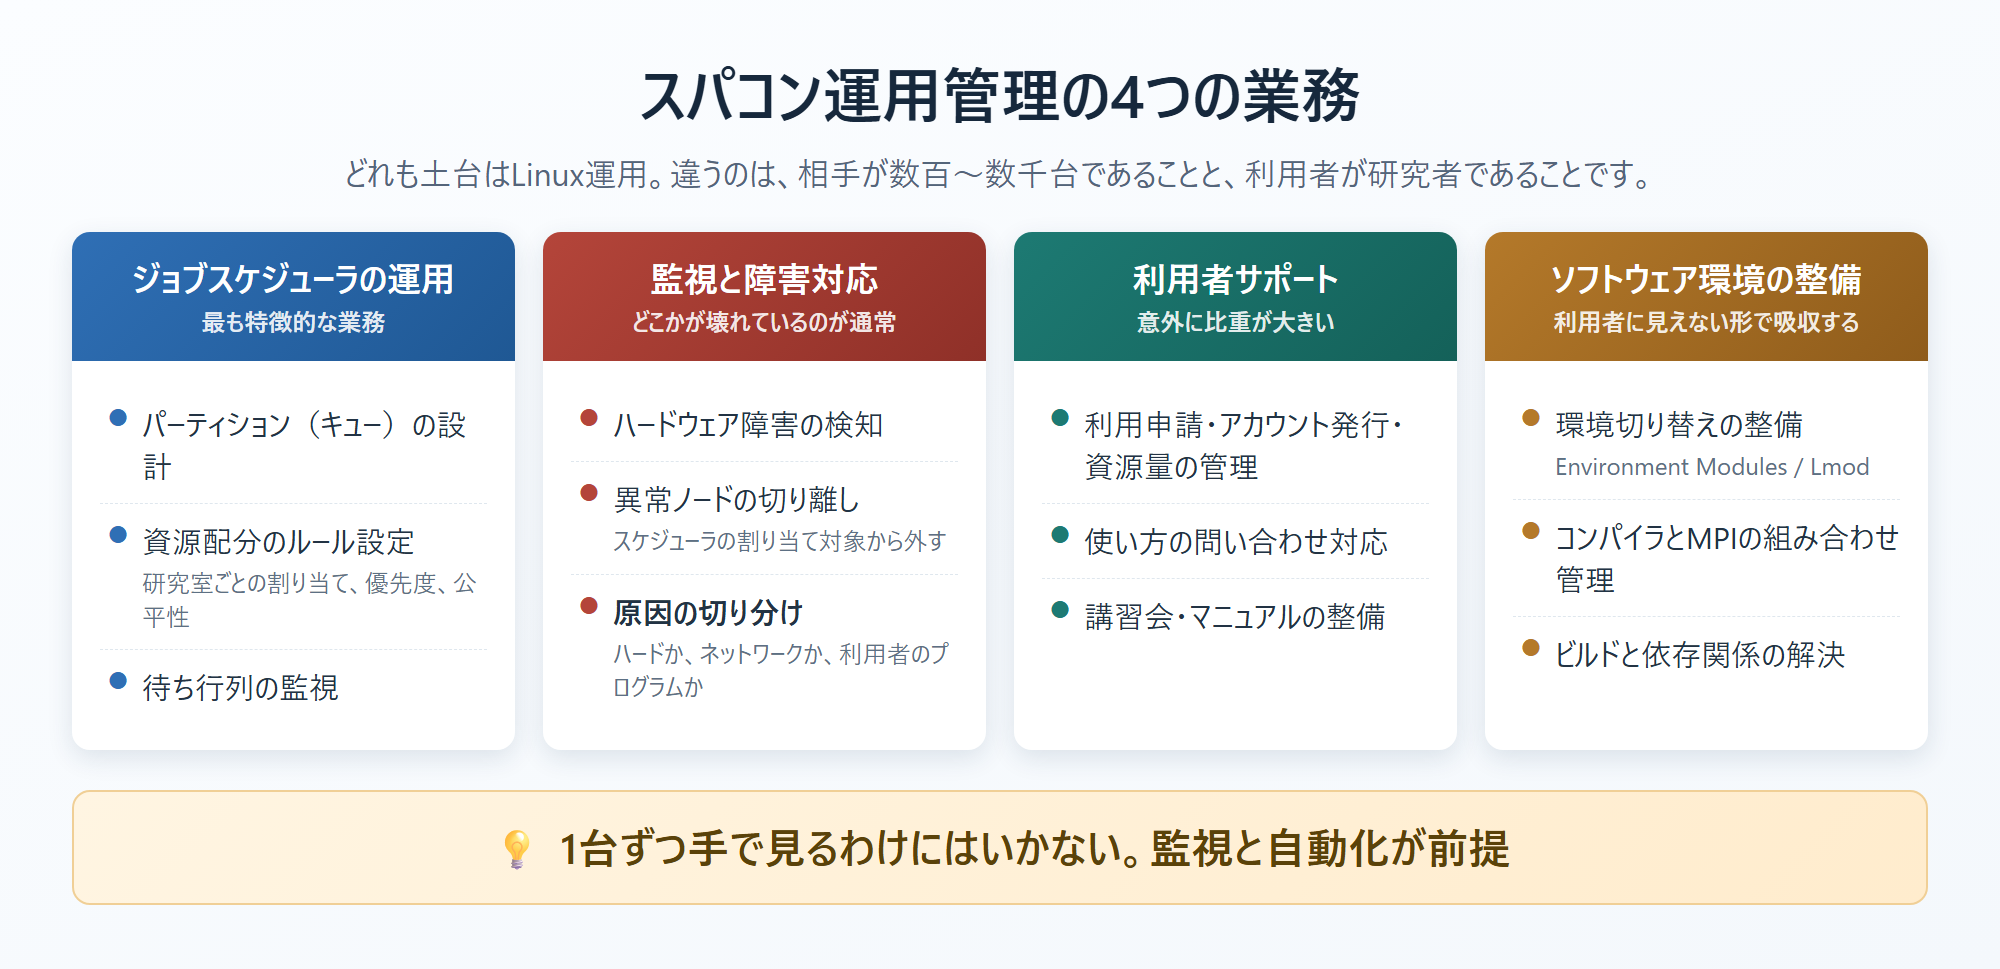
ジョブスケジューラの運用
スパコンの運用管理で、最も特徴的な業務です。
利用者はログインノードから計算を直接実行するのではなく、必要な計算資源と実行時間を指定して「ジョブ」を投入します。スケジューラがそれを受け取り、空いている計算ノードに割り当てます。
広く使われているのは Slurm(Simple Linux Utility for Resource Management)です。ほかに PBS Professional、LSF、Grid Engine などもあります。
利用者が使う基本コマンドは次のとおりです。
| コマンド | 用途 |
|---|---|
sbatch | バッチジョブを投入する |
squeue | 実行中・待機中のジョブを確認する |
sinfo | ノードとキューの状態を確認する |
srun | 対話的にジョブを実行する |
scancel | ジョブを取り消す |
sacct | 完了したジョブの記録を確認する |
scontrol | ジョブや設定を変更する(管理者寄り) |
コマンドの具体的な使い方とジョブスクリプトの書き方は、Slurm入門|sbatch・squeue・sinfoの基本と運用の勘所 にまとめています。
運用側の仕事は、これらが正しく動く状態を保つことです。
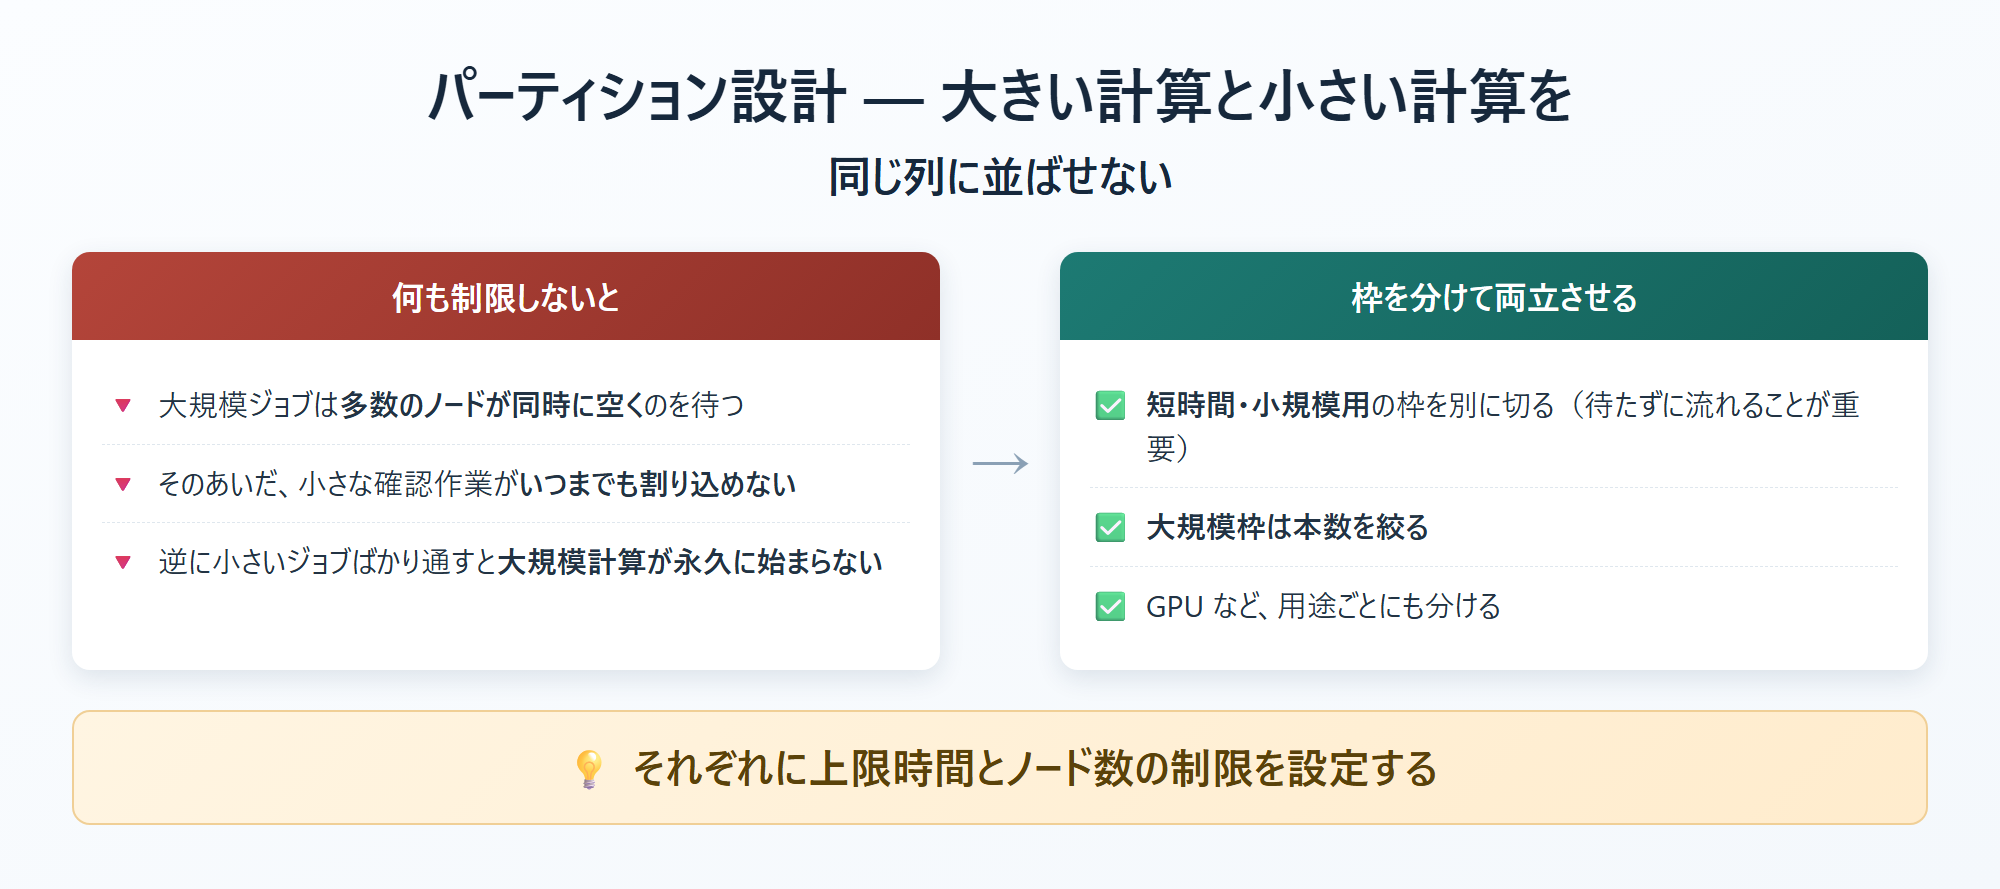
- パーティション(キュー)の設計 — 短時間ジョブ用、大規模ジョブ用、GPU用などに分け、それぞれに上限時間やノード数の制限を設定する
- 資源配分のルール設定 — 研究室ごとの割り当て、優先度(QoS)、公平性の調整
- 待ち行列の監視 — 特定の利用者がキューを占有していないか、待ち時間が異常に伸びていないか
- 投入できないという問い合わせへの対応 — 多くは指定方法の誤りだが、設定側の問題のこともある
パーティション設計の考え方は、ひとことで言えば「大きい計算と小さい計算を同じ列に並ばせない」ことです。大規模ジョブは多数のノードが同時に空くのを待つため、何も制限しないと小さな確認作業がいつまでも割り込めません。逆に小さいジョブばかり通すと、大規模計算が永久に始まりません。短時間用の枠を別に切り、大規模枠は本数を絞る、という形で両立させます。
計算ノードの監視と障害対応
数百から数千のノードがあるため、どこかが壊れているのが通常の状態です。1台ずつ手で見るわけにはいかないので、監視と自動化が前提になります。
主な業務は次のとおりです。
- ハードウェア障害の検知 — メモリエラー、ディスク故障、電源・冷却系の異常
- ノードの切り離し — 異常なノードをスケジューラの割り当て対象から外す(
scontrolでDRAIN状態にするなど) - 原因の切り分け — ジョブが落ちたとき、ハードウェアなのか、ネットワークなのか、利用者のプログラムなのかを判別する
- ネットワークの確認 — InfiniBand などの高速インターコネクトの状態確認。ここが不調だと、ノード単体は正常でも並列計算だけが遅くなる、わかりにくい障害になる
- 並列ファイルシステムの管理 — Lustre、GPFS、BeeGFS など。数百ノードが同時にI/Oするため、一般的なNFSとは考え方が違う
切り分けがこの仕事の核心です。利用者からは「ジョブが落ちた」としか報告されません。そこからログを追い、ハード起因なのかプログラム起因なのかを判断します。
よくある症状と、切り分けの進め方
HPCの障害対応で繰り返し出てくるのは、おおむね次の3パターンです。順に見ていきます。
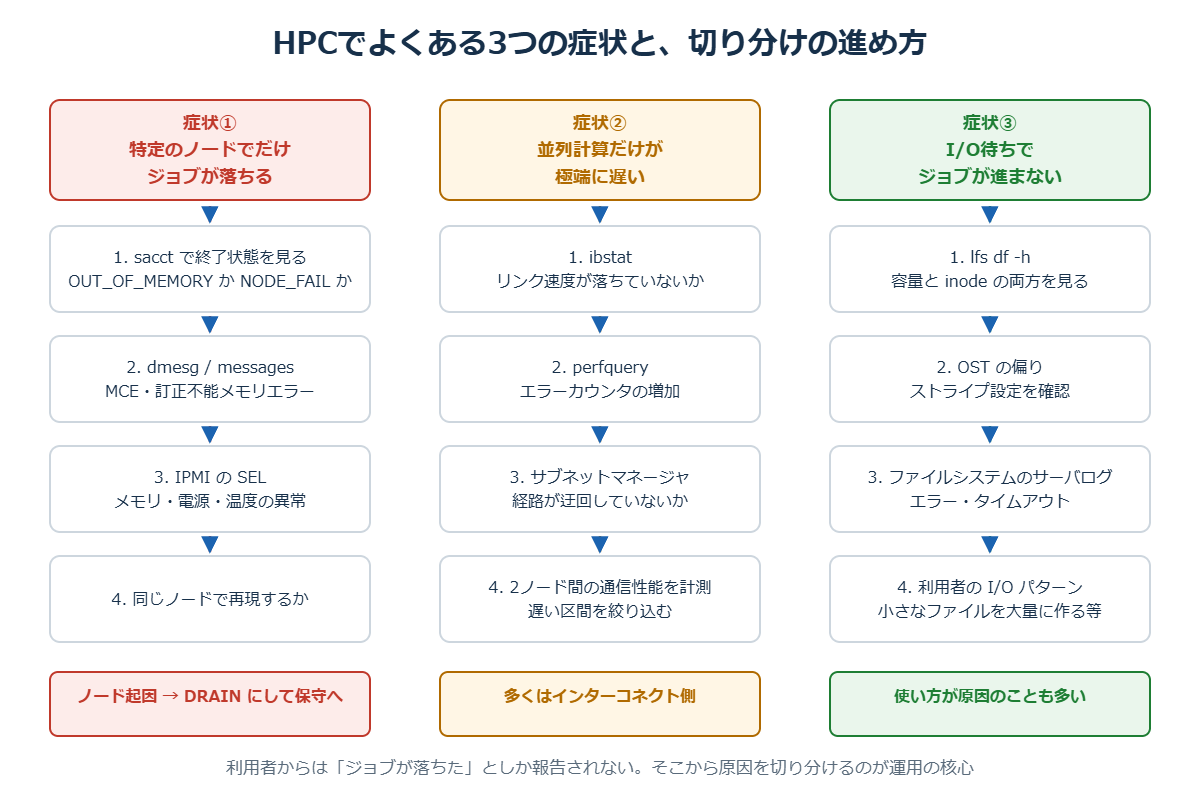
① 特定のノードでだけジョブが落ちる
同じプログラムが他のノードでは完走するのに、あるノードに当たったときだけ落ちる場合です。ハードウェア障害を最初に疑います。
見る順番の一例です。
- スケジューラの記録 —
sacctで終了コードと終了状態を確認する。OUT_OF_MEMORYなら要求メモリ不足、NODE_FAILならノード側の問題 - カーネルログ — 該当ノードの
dmesgや/var/log/messagesに、MCE(Machine Check Exception)や訂正不能メモリエラーが出ていないか - ハードウェアのイベントログ — IPMI の SEL(System Event Log)に、メモリ・電源・温度の異常が記録されていないか
- 再現性の確認 — 同じノードを指定してもう一度流し、再現するかを見る
ノード起因と判断できたら、scontrol で DRAIN にして割り当てから外し、保守に回します。理由(Reason)を必ず書き残すのが実務上は重要で、これが後から見たときの引き継ぎ情報になります。
② 並列計算だけが極端に遅い
ノード単体のベンチマークは正常なのに、複数ノードを使った計算だけが遅い。最も見つけにくい障害です。
多くの場合、原因はノードではなくノード間をつなぐインターコネクトにあります。
- リンク速度の確認 — InfiniBand なら
ibstatで各ポートの状態と速度を見る。規定より低い速度でリンクしているポートがないか - エラーカウンタの確認 —
perfqueryなどでポートのエラーカウンタを見る。シンボルエラーやリンクダウン回数が増え続けているポートは、ケーブルやトランシーバの劣化が疑われる - 経路の確認 — サブネットマネージャのログを見て、経路が意図せず迂回していないか
- 切り分けの定番 — ノード2台だけの通信性能を測り、組み合わせを変えながら遅い区間を絞り込む
リンクは「切れていない」が「遅い」という状態になりうるのが厄介な点です。死活監視だけでは拾えないため、速度とエラーカウンタを継続的に記録しておくことが効きます。
③ I/O待ちでジョブが進まない
CPU使用率が上がらず、プロセスがI/O待ちのまま滞留する場合です。並列ファイルシステム側を疑います。
- 容量の確認 — Lustre なら
lfs df -hで、OST(データ格納領域)と MDT(メタデータ領域)の両方を見る。容量より先にメタデータ領域(inode)が枯渇することがある - 特定の領域への偏り — 一部のOSTだけ使用率が突出していないか。ストライプ設定が適切でないと偏りが出る
- サーバ側のログ — ファイルシステムのサーバでエラーやタイムアウトが出ていないか
- 利用者のI/Oパターン — 「小さなファイルを大量に作る」「全ノードが同じファイルを同時に開く」といった処理は、並列ファイルシステムが最も苦手とするパターン。この場合はシステムではなくプログラム側の問題
③はシステムの障害ではなく、使い方が原因であることが相当あるのが特徴です。だからこそ、運用側が原因を切り分けて利用者に伝える意味があります。
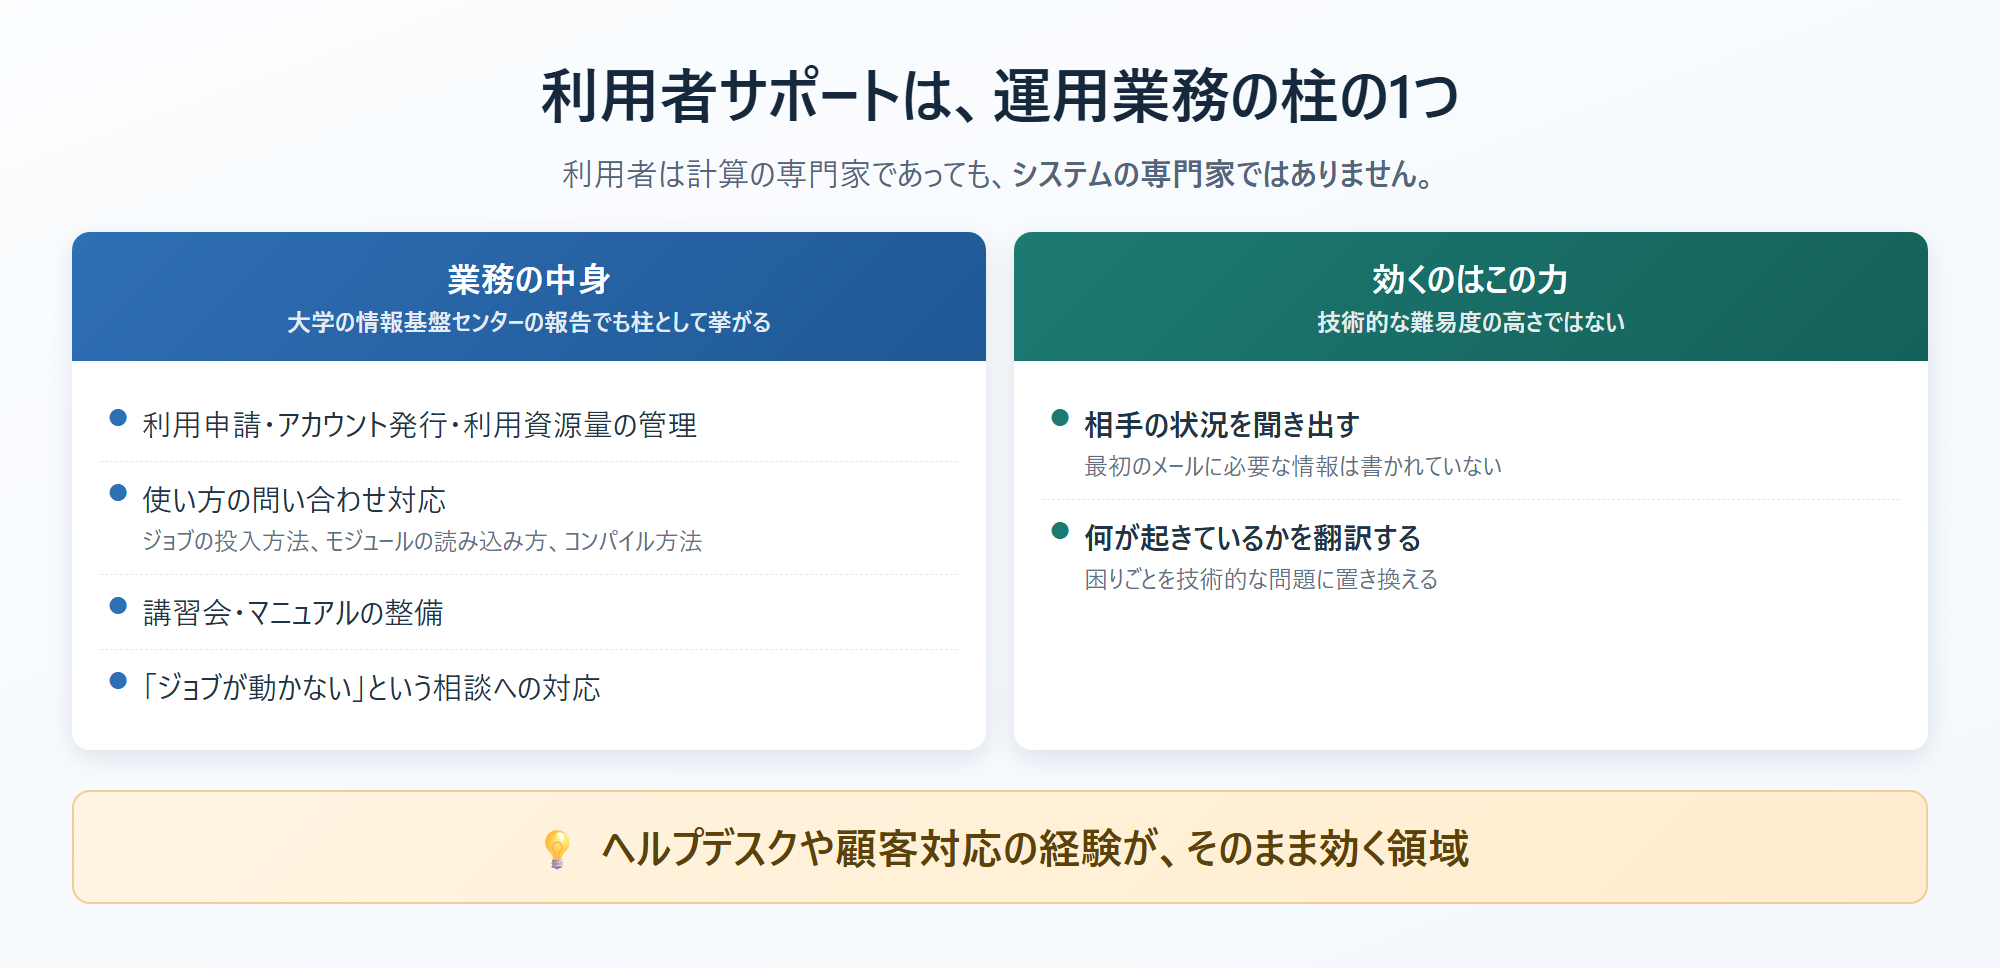
利用者サポート
意外に比重の大きい業務です。利用者は計算の専門家であっても、システムの専門家ではありません。
- 利用申請・アカウント発行・利用資源量の管理
- 使い方の問い合わせ対応(ジョブの投入方法、モジュールの読み込み方、コンパイル方法)
- 講習会・マニュアルの整備
- ジョブが動かないという相談への対応
大学の情報基盤センターなどの報告でも、利用登録や申請処理、問い合わせ対応、講習会といった利用者支援が運用業務の柱として挙げられています。
技術的な難易度が高いというより、相手の状況を聞き出して、何が起きているかを翻訳する力が要る仕事です。
ソフトウェア環境の整備
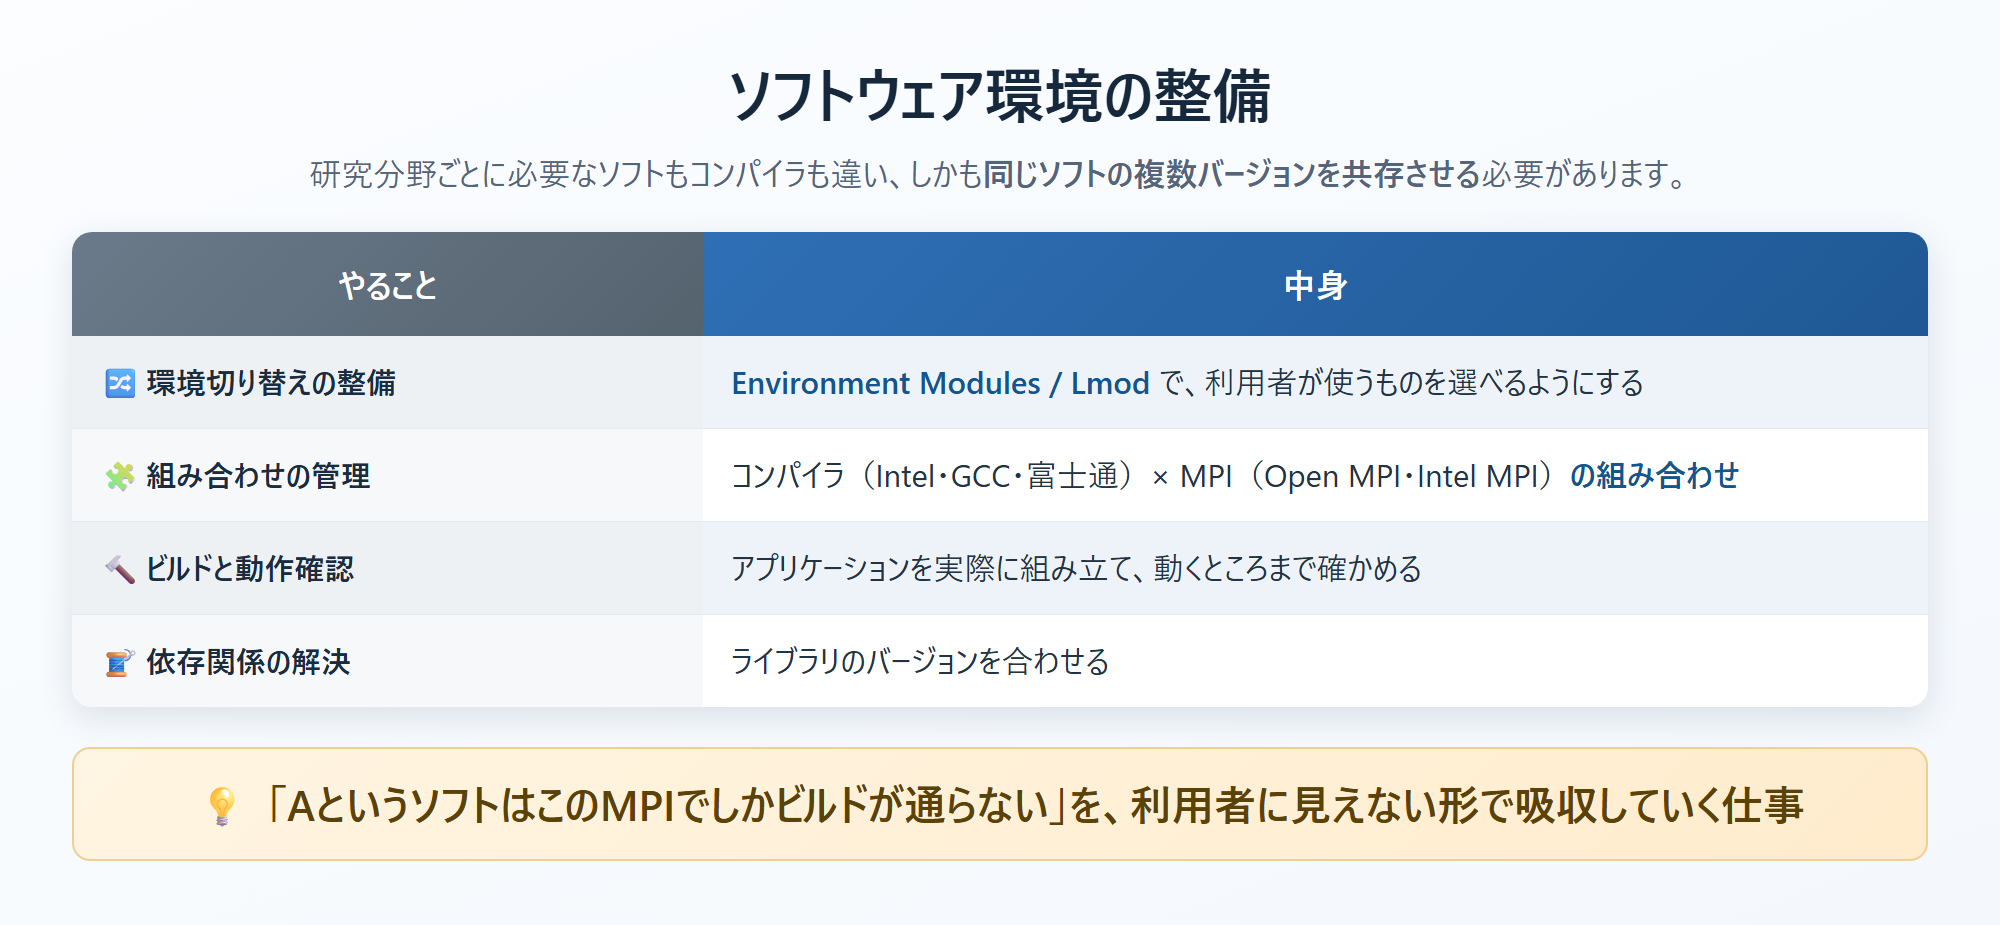
研究分野ごとに必要なソフトウェアもコンパイラも違い、しかも同じソフトの複数バージョンを共存させる必要があります。
- Environment Modules / Lmod による環境切り替えの整備
- コンパイラ(Intel、GCC、富士通コンパイラなど)とMPI(Open MPI、Intel MPIなど)の組み合わせ管理
- アプリケーションのビルドと動作確認
- ライブラリの依存関係の解決
「AというソフトはこのMPIでしかビルドが通らない」といった事情を、利用者に見えない形で吸収していく仕事です。
求められるスキル
一般的なインフラエンジニアとの違いをもう少し詳しく知りたい方は、HPCエンジニアの仕事内容|インフラ運用と何が違うのか もあわせてどうぞ。
ここまで読んで気づかれたと思いますが、必要なスキルの大半はLinux運用の経験そのものです。
| スキル | 位置づけ |
|---|---|
| Linux/UNIXの運用管理 | 必須。 土台はこれ |
| シェルスクリプト(sh、Bash)での自動化 | 必須。 数百ノードを手作業では扱えない |
| ネットワークの基礎知識 | 必須。インターコネクトの切り分けに使う |
| ログを追って原因を切り分ける力 | この仕事の中心 |
| Python、Perl などのスクリプト言語 | 運用ツールの作成・改修に使う |
| ジョブスケジューラの知識 | 入ってから覚えられる |
| 並列計算・MPIの知識 | あると強いが、必須ではない |
| 研究分野の専門知識 | 不要。利用者が専門家 |
スパコン固有の知識は、入ってから身につくものがほとんどです。 逆に、Linuxの運用経験とログを追う力は、後から短期間で身につくものではありません。すでにお持ちの経験が、そのまま効く領域です。
最初に戸惑いやすいところ
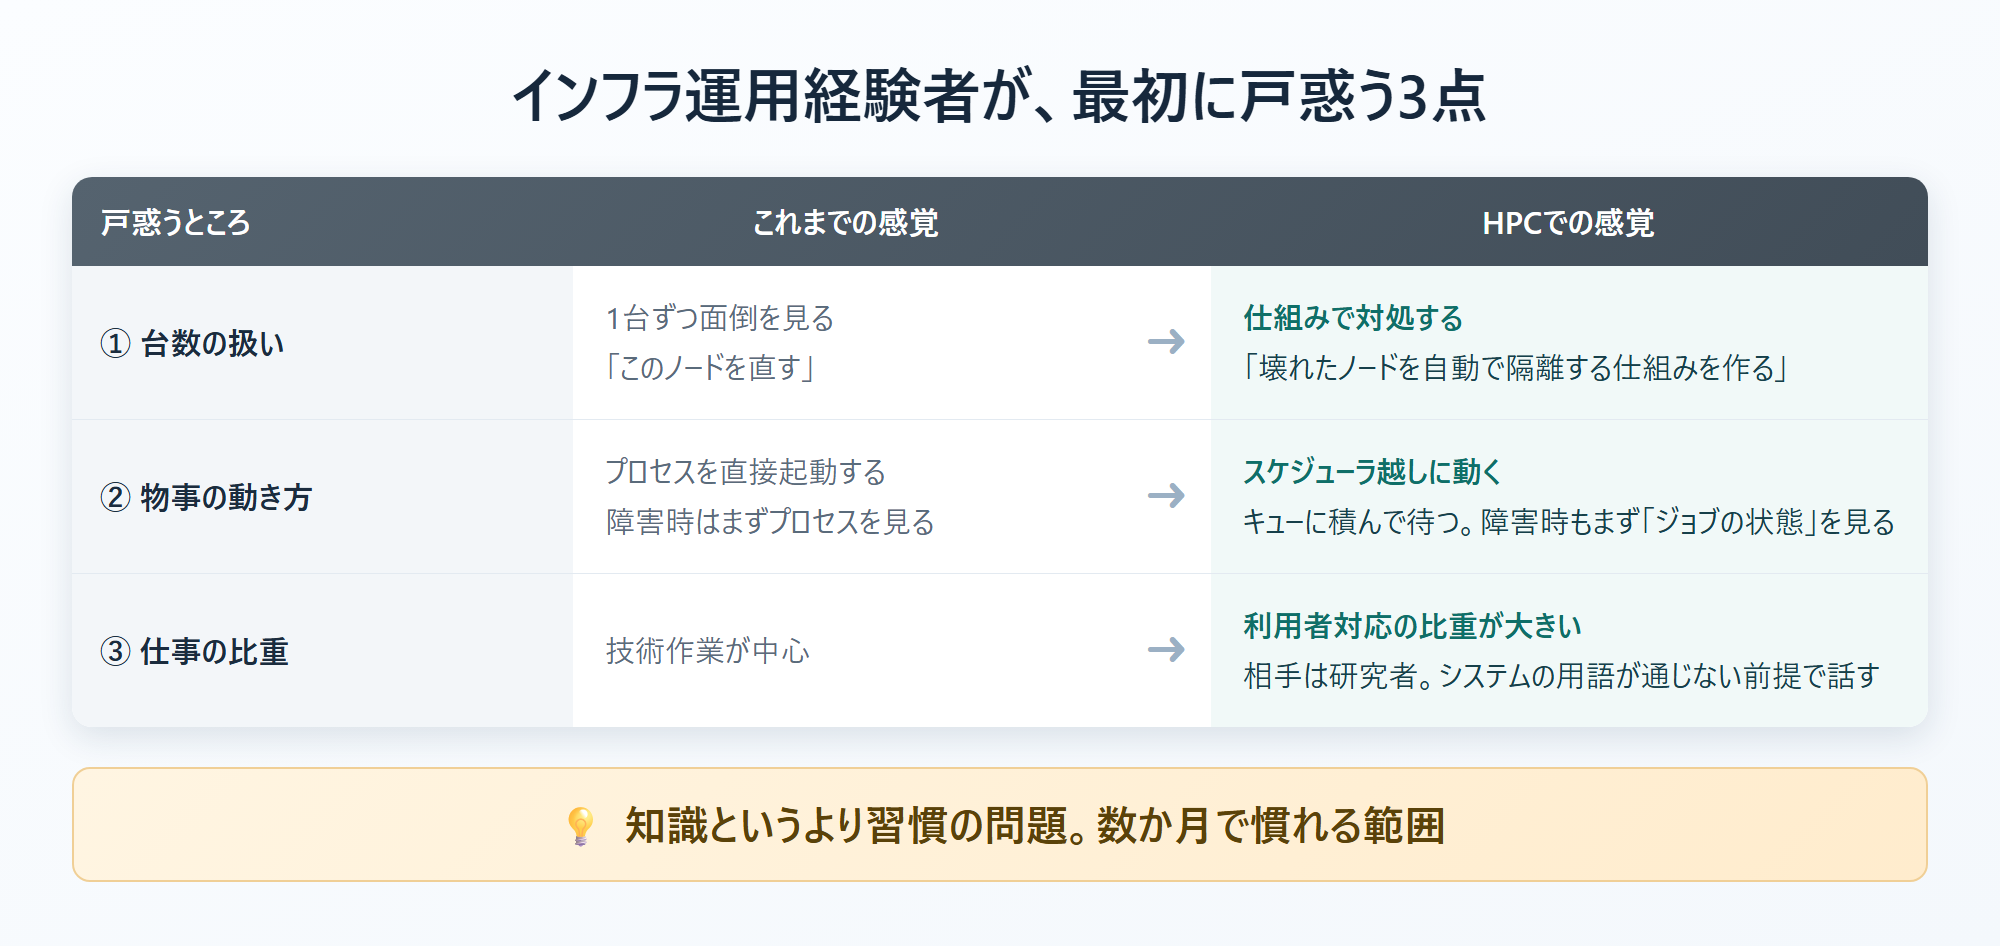
一般的なサーバ運用の経験がある方が、HPCに入って最初に感覚の切り替えを求められるのは、だいたい次の3点です。
- 1台ずつ面倒を見ない — 数百台が相手なので、「このノードを直す」より「壊れたノードを自動で隔離する仕組みを作る」という発想に変わります
- スケジューラ越しに物事が動く — プロセスを直接起動せず、キューに積んで待つ。トラブル時も「プロセスを見る」前に「ジョブの状態を見る」のが先になります
- 利用者対応の比重が大きい — 技術作業だけの仕事ではありません。相手は研究者で、システムの用語が通じない前提で話す必要があります
いずれも知識というより習慣の問題で、数か月で慣れる範囲です。
よくある質問
研究の知識がないと務まりませんか?
必要ありません。研究内容を理解するのは利用者の仕事で、運用側に求められるのは計算基盤を正常に動かすことです。利用者と話が通じる程度に、計算の流れを把握していれば十分です。
常駐や夜勤が必要な仕事ですか?
システムと契約形態によります。24時間の有人監視を行う体制もあれば、監視は自動化してリモートで対応する体制もあります。sshで接続できれば作業の大半は完結するため、リモートで成立しやすい仕事でもあります。
CATIPがご紹介しているLinuxシステム運用管理の案件は、全国どこからでも在宅で勤務できるフルリモートです。勤務する曜日と時間帯はご自身で選べて、土日祝はお休み。時給3,000円〜で、直接雇用契約と業務委託契約を選べます。
ブランクがあっても大丈夫でしょうか?
Linuxの運用管理は、根本的な考え方が長く変わらない領域です。ツールの名前が変わっても、ログを読んで原因を切り分けるという仕事の本質は同じです。ブランクより、過去にどれだけ現場で切り分けをしてきたかのほうが効きます。
まとめ
スーパーコンピュータの運用管理は、特別な世界の仕事ではなく、Linuxサーバ運用の経験が直接活きる仕事です。
- 実体は大規模なLinuxクラスタ。OSもコマンドも見慣れたもの
- 「止めないこと」より 「やり直させないこと」 が重視される
- 業務の柱は、ジョブスケジューラの運用/監視と障害切り分け/利用者サポート/ソフトウェア環境の整備
- よくある障害は「特定ノードで落ちる」「並列だけ遅い」「I/O待ちで進まない」の3パターン
- スパコン固有の知識は入ってから覚えられる。 Linux運用経験とログを追う力のほうが重要
これまで培ってきた運用の経験を活かせる場所は、思っているより近くにあります。
参考にした情報
- Slurmの基本コマンドと、ログインノードから計算ノードへジョブを投入する仕組み — OIST Slurm利用ガイド / DDBJ Slurmの使い方 / 理化学研究所 R-CCS Slurmドキュメント
- HPC運用の業務範囲(監視・障害検知、ログ管理、障害切り分け、技術問い合わせ対応、利用者トレーニング) — NEC HPC運用支援
- 大学の情報基盤センターにおける利用者支援業務(利用登録・申請処理、問い合わせ対応、講習会) — AXIES 学術情報基盤オープンフォーラム 発表資料
この記事について
この記事は、株式会社計算科学 高度情報人材支援センター(CATIP)HPCエンジニアチームが執筆・監修しています。執筆体制と記事作成のポリシーは 執筆・監修者について をご覧ください。
Linux/UNIX の運用経験を、在宅で活かしませんか
この記事を公開している CATIP(高度情報人材支援センター) では、Linux/UNIXサーバの運用管理のご経験がある方に、お仕事をご紹介しています。
全国どこからでも在宅で、勤務する曜日も時間もご自身で選べます。
- フルリモート(全国47都道府県から応募できます)
- 勤務日・勤務時間は自由選択。土日祝はお休み
- 時給 3,000円〜
- 直接雇用契約と業務委託契約を選べます(派遣ではありません)
- 50代・60代の方、ブランクのある方も歓迎しています
「もう現場から離れている」「フルタイムは難しい」という方こそ、一度ご覧ください。オファー時に仕事の内容をご提示したうえで、受けるかどうかを選んでいただけます。受けない場合の不利益はありません。