スーパーコンピュータや計算クラスタを初めて触ると、まず戸惑うのが「プログラムを直接実行してはいけない」というルールです。
ログインしたサーバで ./a.out と打つのではなく、ジョブスケジューラに「お願い」を出して順番を待つ。この仕組みの中心にあるのが Slurm です。
この記事では、Slurm の基本コマンドとジョブスクリプトの書き方を説明します。あわせて、運用側がSlurmの何を管理しているのかまで踏み込みます。利用者向けの解説は各センターのマニュアルにありますが、運用視点の日本語情報はほとんどないためです。
ジョブスケジューラとは何か
計算クラスタには、役割の違う2種類のサーバがあります。
| 種類 | 役割 |
|---|---|
| ログインノード | 利用者が ssh で接続する入口。ファイル編集やコンパイルを行う |
| 計算ノード | 実際の計算を実行する。数十〜数千台 |
利用者が計算ノードに直接ログインして実行すると、同じノードに複数人の計算が集中して共倒れします。これを避けるために、計算の実行を仲介するのがジョブスケジューラです。
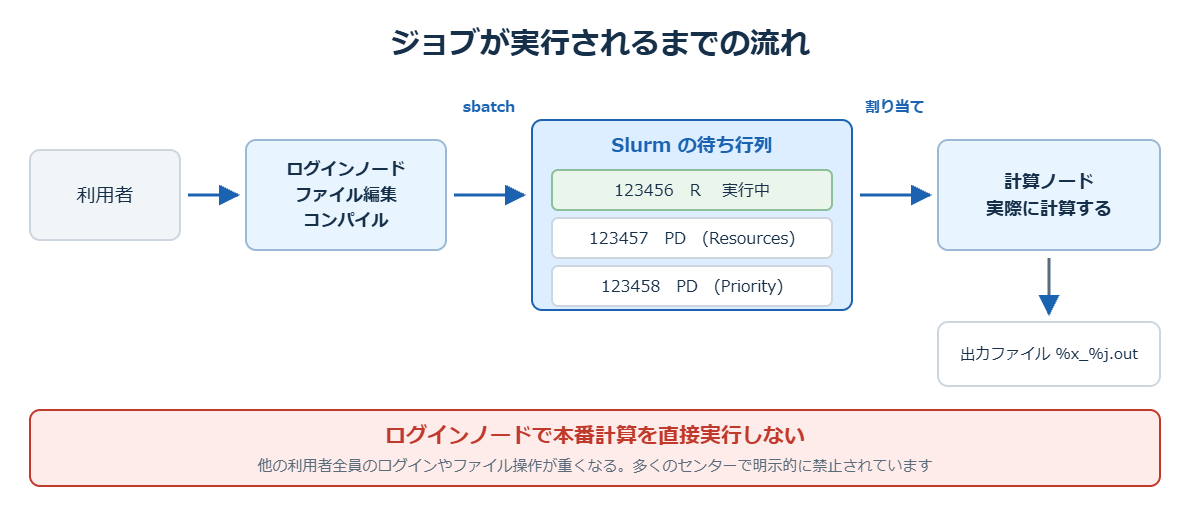
Slurm(Simple Linux Utility for Resource Management)は、このジョブスケジューラの中で最も広く使われているものです。オープンソースで、国内外の研究機関・大学・企業の計算クラスタで標準的に採用されています。
ほかに PBS Professional、LSF、Grid Engine などもあります。考え方はどれも共通なので、1つ覚えれば他にも応用が効きます。
ジョブスケジューラの運用が、スパコン運用の中でどういう位置づけにあるかは、スーパーコンピュータの運用管理とは|Linuxエンジニアの仕事 にまとめています。
基本コマンド
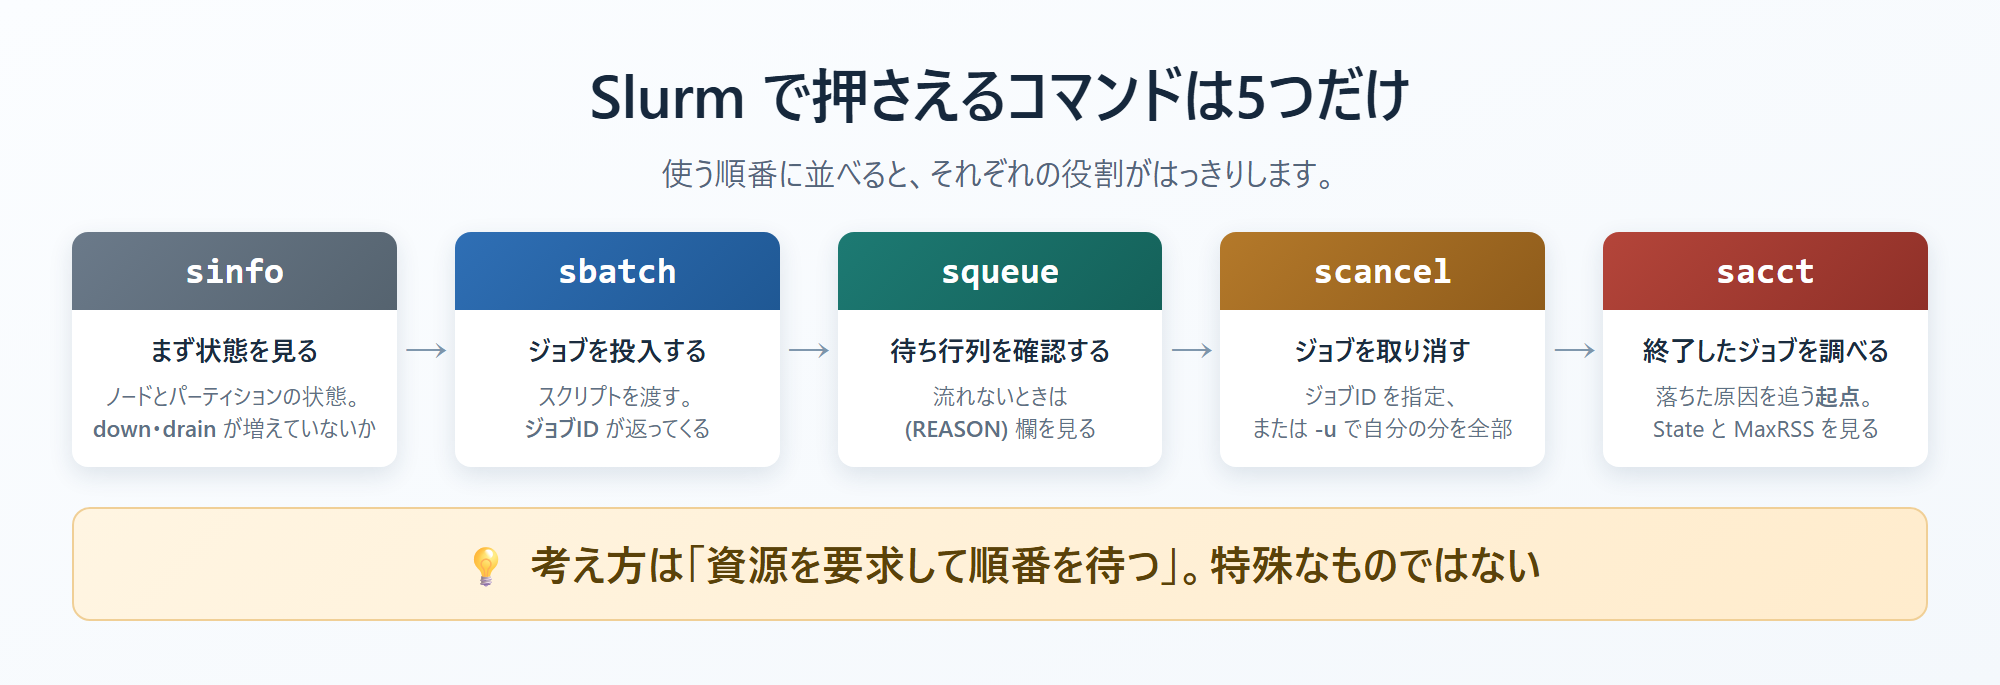
まず押さえるべきは次の5つです。
| コマンド | 用途 |
|---|---|
sinfo | ノードとパーティションの状態を見る |
sbatch | ジョブを投入する |
squeue | 待ち行列を確認する |
scancel | ジョブを取り消す |
sacct | 終了したジョブの記録を見る |
sinfo — まず状態を見る
$ sinfo
PARTITION AVAIL  TIMELIMIT  NODES  STATE NODELIST
debug*       up      30:00      2   idle node[001-002]
regular      up 1-00:00:00     48  alloc node[003-050]
regular      up 1-00:00:00      6   idle node[051-056]
gpu          up 1-00:00:00      4   down node[057-060]
読み方は次のとおりです。
| 列 | 意味 |
|---|---|
| PARTITION | キューの名前。* が付いているのが既定 |
| TIMELIMIT | そのパーティションの最大実行時間 |
| NODES | その状態にあるノード数 |
| STATE | ノードの状態 |
STATE は運用上いちばん重要な情報です。
| STATE | 意味 |
|---|---|
idle | 空いている。すぐ使える |
alloc | ジョブが割り当てられ、使用中 |
mix | 一部のCPUだけ使われている |
drain | 管理者が意図的に新規割り当てを止めている(メンテ・障害対応中) |
down | ノードがダウンしている |
down や drain が増えているときは、ハードウェア障害かメンテナンスが進行中です。利用者から「いつもより待ち時間が長い」と言われたら、まずここを見ます。
sbatch — ジョブを投入する
実行したい内容をシェルスクリプトに書き、sbatch に渡します。
$ sbatch job.sh
Submitted batch job 123456
返ってきた数字がジョブIDです。以降の確認や取り消しに使います。
squeue — 待ち行列を見る
$ squeue -u $USER
JOBID PARTITION  NAME   USER ST  TIME NODES NODELIST(REASON)
123456  regular  calc   user  R  2:13     4 node[003-006]
123457  regular  calc2  user PD  0:00     8 (Resources)
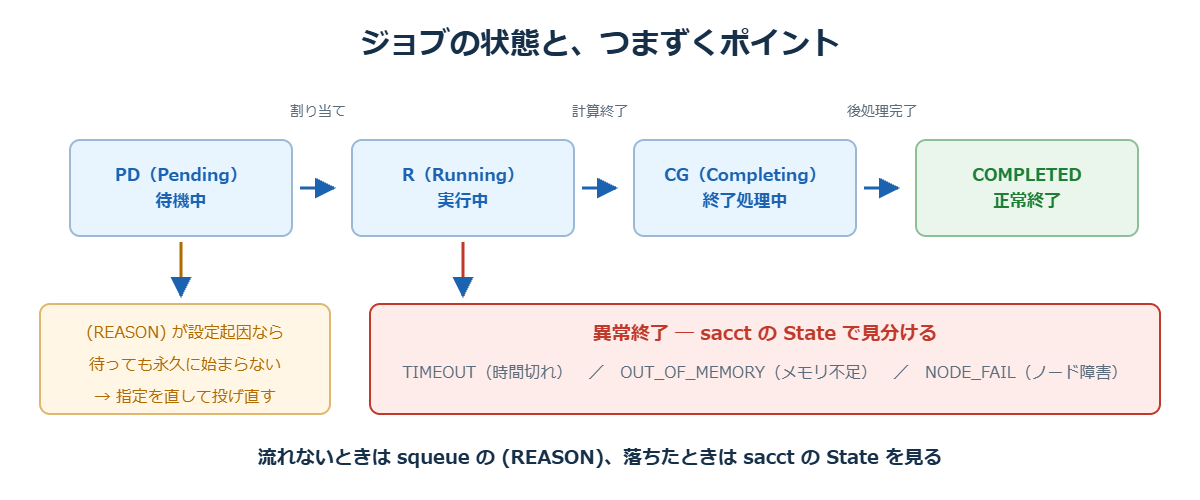
ST(ステータス)の意味です。
| ST | 意味 |
|---|---|
R | Running(実行中) |
PD | Pending(待機中) |
CG | Completing(終了処理中) |
F | Failed(失敗) |
TO | Timeout(制限時間切れ) |
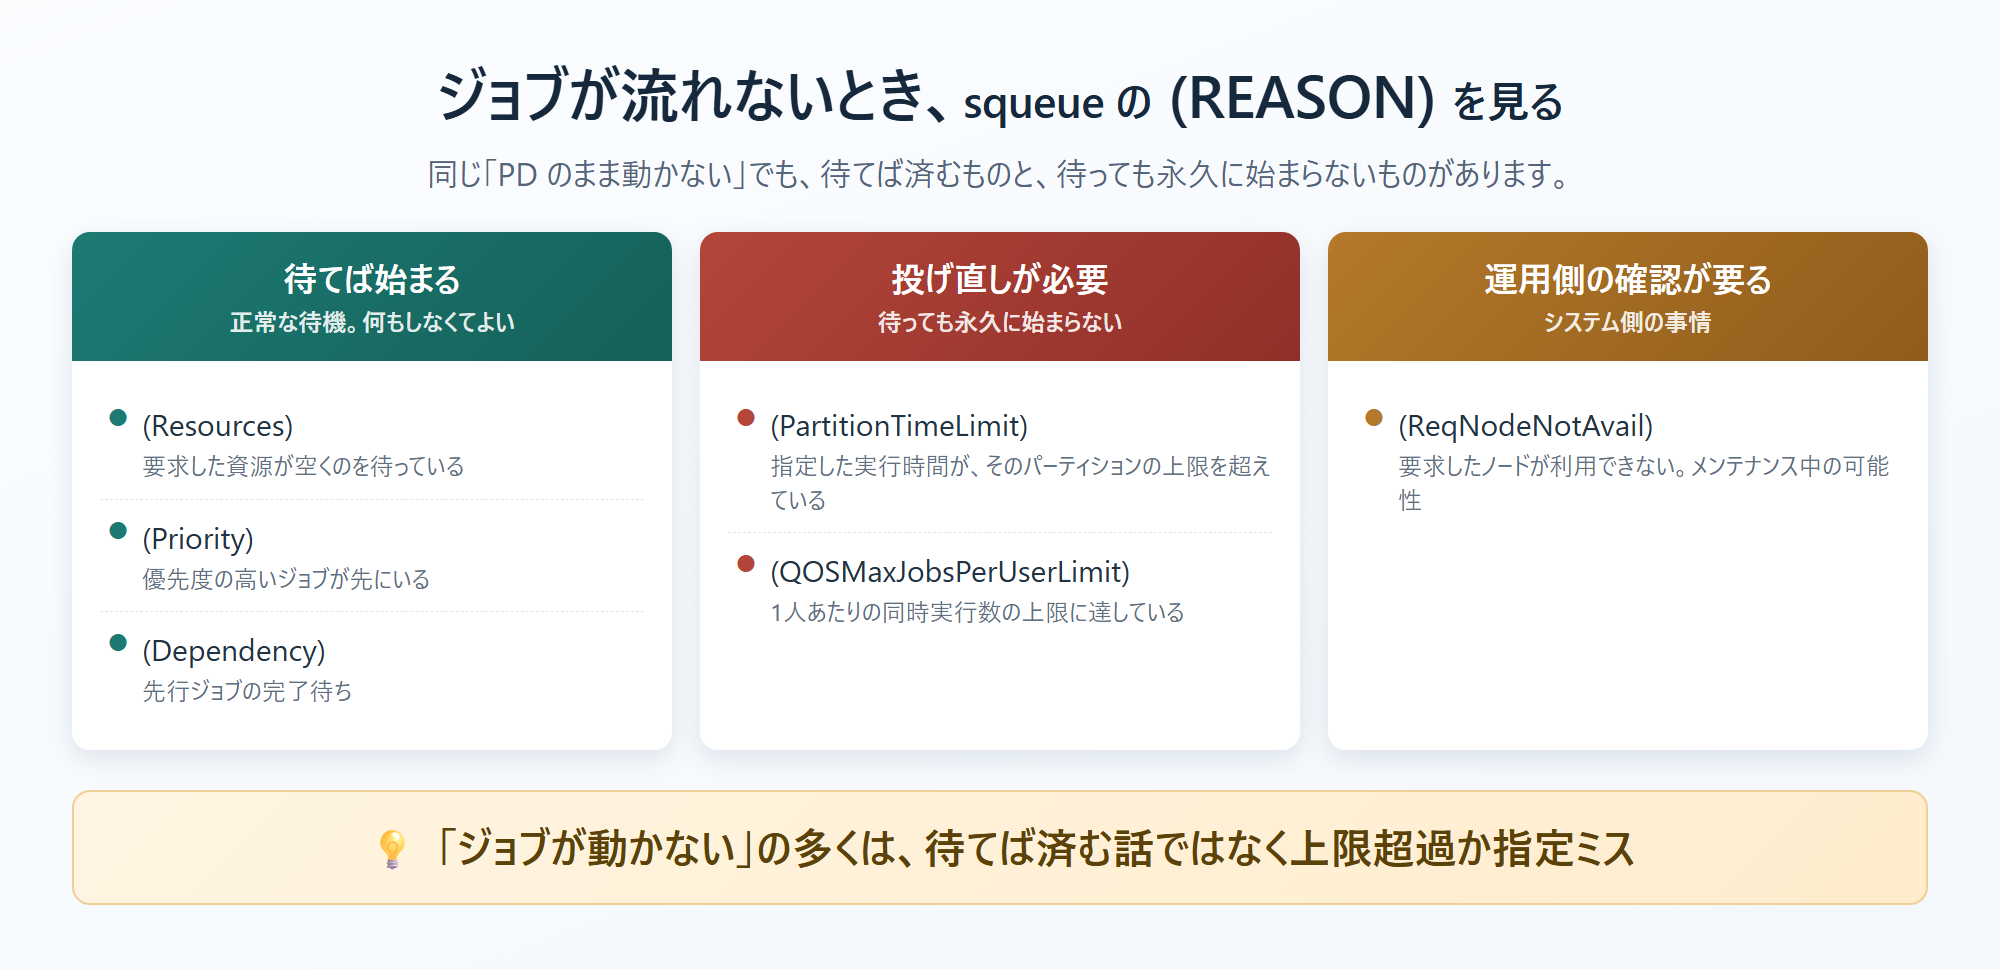
ジョブが流れないときは PD の横の (REASON) を見ます。 ここに原因が書いてあります。
| REASON | 意味と対処 |
|---|---|
(Resources) | 要求した資源が空くのを待っている。正常な待機 |
(Priority) | 優先度の高いジョブが先にいる。正常な待機 |
(QOSMaxJobsPerUserLimit) | 1人あたりの同時実行数の上限に達している |
(PartitionTimeLimit) | 指定した実行時間が、そのパーティションの上限を超えている。投げ直しが必要 |
(ReqNodeNotAvail) | 要求したノードが利用できない。メンテ中の可能性 |
(Dependency) | 先行ジョブの完了待ち |
利用者から「ジョブが動かない」と相談されたとき、最初に確認するのがここです。実際には、上限超過か指定ミスであることがほとんどです。
scancel — 取り消す
$ scancel 123456          # ジョブIDを指定
$ scancel -u $USER        # 自分のジョブを全部
sacct — 終了したジョブを調べる
$ sacct -j 123456 --format=JobID,JobName,State,Elapsed,MaxRSS,ExitCode
ジョブが落ちた原因を調べるときの起点です。
StateがTIMEOUT→ 実行時間の見積もりが足りなかったStateがOUT_OF_MEMORY→ メモリ不足MaxRSSが要求メモリに張り付いている → 同上StateがNODE_FAIL→ ノード側の問題。ハードウェア障害が疑われるExitCodeが 0 以外 → プログラム側のエラー
ここでハード起因なのか利用者のプログラム起因なのかの当たりがつくので、切り分けの時間が大きく変わります。
ジョブスクリプトの書き方
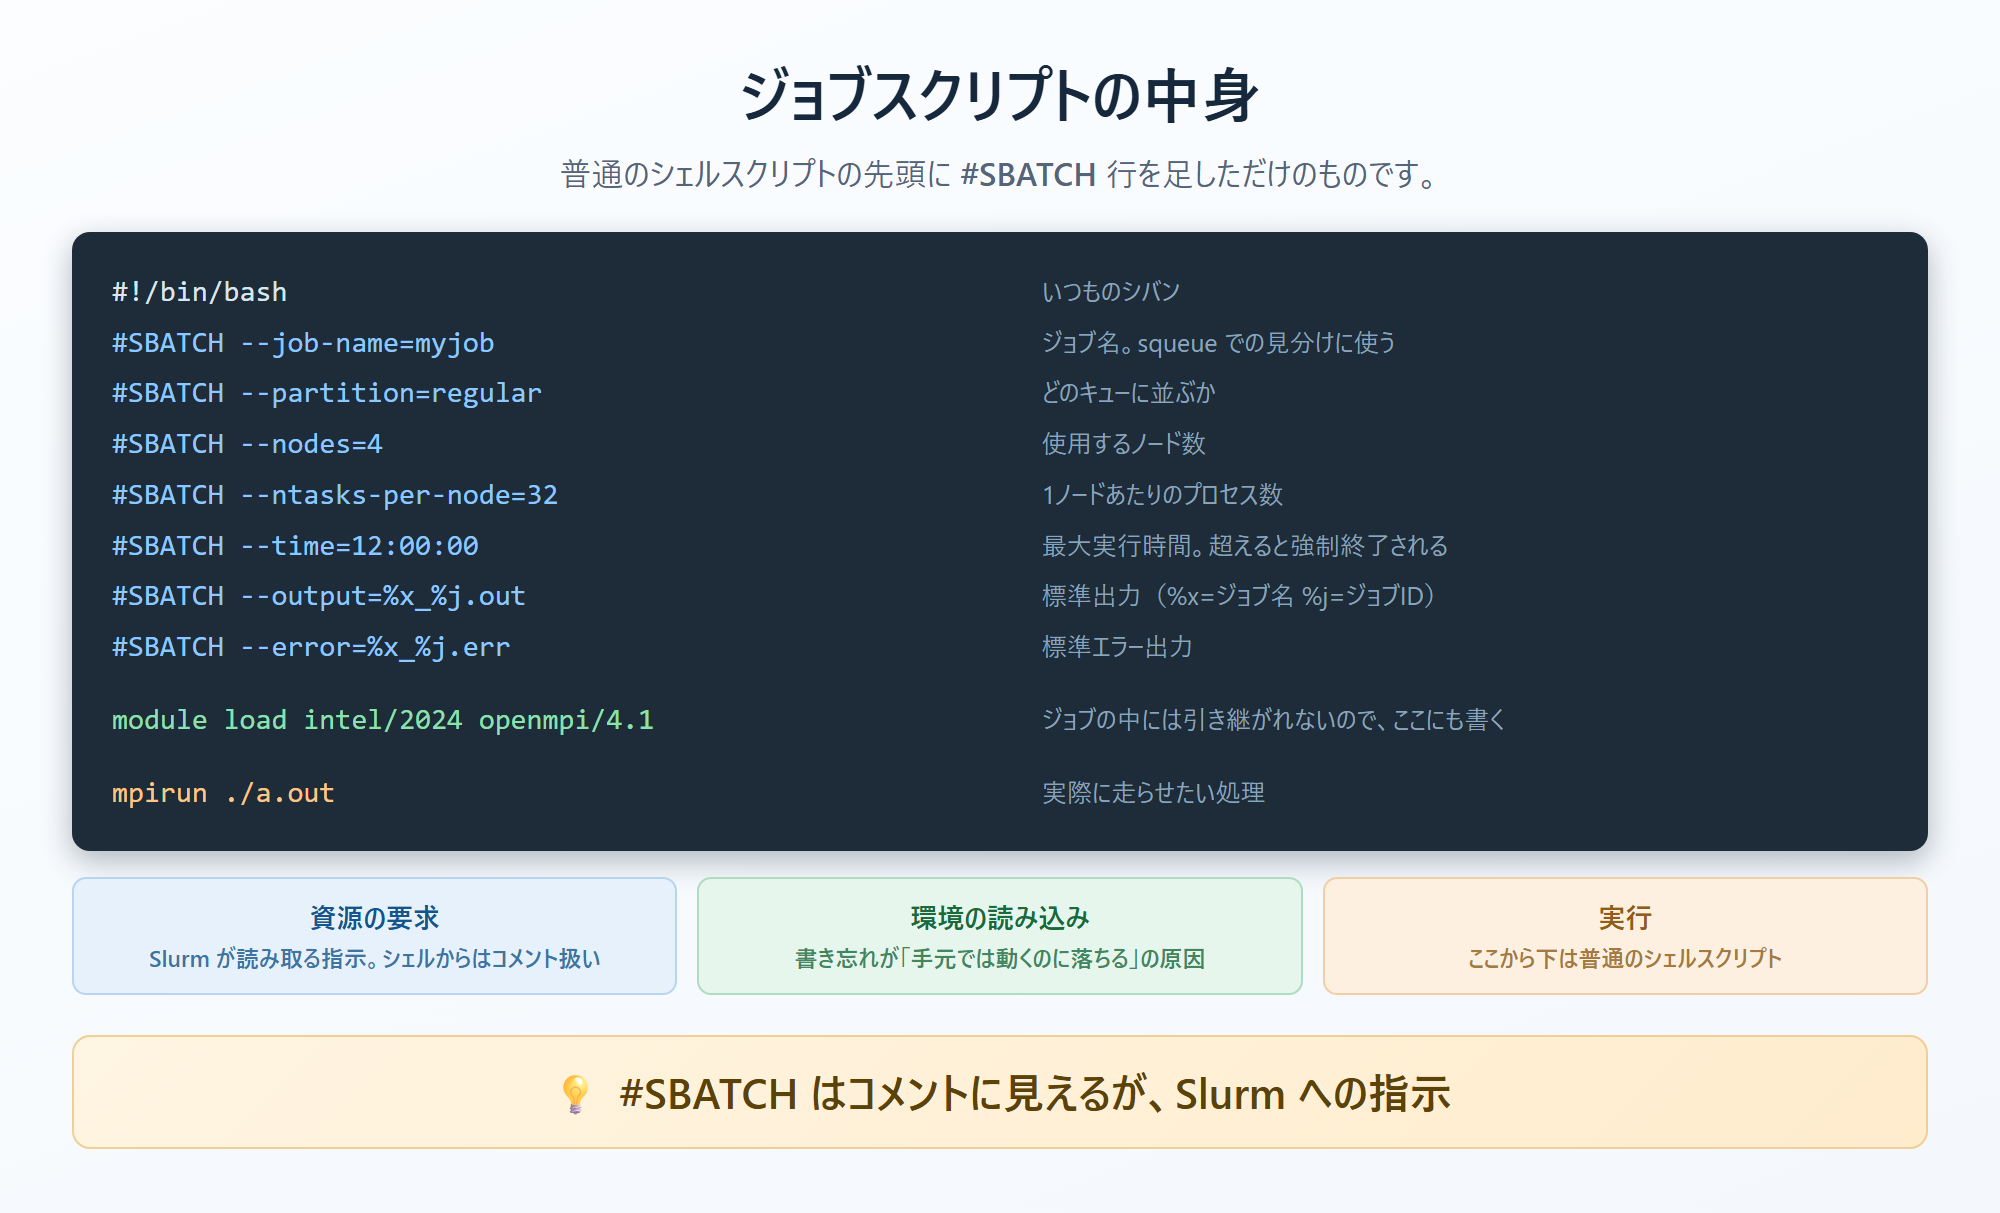
Slurm のジョブスクリプトは、普通のシェルスクリプトの先頭に #SBATCH 行を足したものです。
#!/bin/bash
#SBATCH --job-name=myjob          # ジョブ名
#SBATCH --partition=regular       # 使用するパーティション
#SBATCH --nodes=4                 # ノード数
#SBATCH --ntasks-per-node=32      # 1ノードあたりのプロセス数
#SBATCH --time=12:00:00           # 最大実行時間(時:分:秒)
#SBATCH --output=%x_%j.out        # 標準出力(%x=ジョブ名 %j=ジョブID)
#SBATCH --error=%x_%j.err         # 標準エラー出力

module load intel/2024 openmpi/4.1

mpirun ./a.out
#SBATCH はコメント行に見えますが、Slurm が読み取る指示です。シェルからは無視されるので、同じスクリプトを手元で試すこともできます。
よく使うオプション
| オプション | 意味 |
|---|---|
--job-name / -J | ジョブ名。squeue での見分けに使う |
--partition / -p | パーティション(キュー)の指定 |
--nodes / -N | 使用するノード数 |
--ntasks / -n | 総プロセス数 |
--ntasks-per-node | 1ノードあたりのプロセス数 |
--cpus-per-task / -c | 1プロセスあたりのCPUコア数(OpenMP用) |
--mem | 1ノードあたりのメモリ量(例 --mem=64G) |
--time / -t | 最大実行時間。超えると強制終了される |
--account / -A | 課金先プロジェクト。複数所属時に必要 |
--gres=gpu:2 | GPUの枚数 |
--dependency=afterok:123456 | 先行ジョブの正常終了後に実行 |
つまずきやすいポイント
ここからは、利用者サポートで繰り返し出てくるパターンです。エラーの出方から原因を当てるのがコツになります。
① そもそもジョブが始まらない
squeue で PD のまま動かない場合、原因は (REASON) 欄に書いてあります。
(Resources) や (Priority) なら正常な待機なので、ただ待てば始まります。一方、(PartitionTimeLimit) や (QOSMaxJobsPerUserLimit) は待っても永久に始まりません。 指定を直して投げ直す必要があります。
「ジョブが動かない」という相談の多くが、この後者です。まず (REASON) を見る習慣をつけるだけで、大半は自己解決できます。
② 時間切れで打ち切られた
sacct の State が TIMEOUT なら、--time で指定した上限を超えたということです。警告なく打ち切られ、計算結果は残りません。
ここで注意が必要なのは、--time は長く取ればいいわけではないという点です。実行時間を長く指定すると、スケジューラはその長さの空きが出るまで待たせます。結果として、短く指定したジョブより大幅に遅く始まります。
実測に少し余裕を足した値が、最も早く回る設定です。
そして長時間ジョブは、チェックポイント(途中状態の保存)を必ず実装してください。これはHPC利用の基本作法です。途中保存があれば、時間切れでもメンテナンスでも、続きから再開できます。
③ メモリ不足で落ちた
State が OUT_OF_MEMORY、または MaxRSS が要求メモリにぴったり張り付いている場合です。--mem または --mem-per-cpu を増やして投げ直します。
ただし要求メモリを増やすと、その分だけ空き待ちが長くなります。 一度 sacct で実際の使用量を測り、それに合わせるのが結局いちばん早く回ります。
④ 手元では動くのに、ジョブにすると落ちる
ライブラリが見つからない、コマンドが無い、といったエラーで落ちる場合です。原因はほぼ module load の書き忘れです。
ログインノードで対話的に作業しているときに読み込んだモジュールは、ジョブの中には引き継がれません。 コンパイル時と実行時で環境が違うと、リンクしたはずのライブラリが見つからず落ちます。ジョブスクリプトの中にも module load を書くのが安全です。
⑤ ログインノードで直接実行してしまう
コンパイルや軽い確認は構いませんが、本番計算をログインノードで走らせると、他の利用者全員のログインやファイル操作が重くなります。
運用側が最も困る行為で、多くのセンターで明示的に禁止されています。気づかずにやってしまう方が一定数いるため、講習会や初回案内で必ず触れる項目です。
運用側はSlurmの何を管理しているのか
ここからは、利用者向けマニュアルには載っていない部分です。
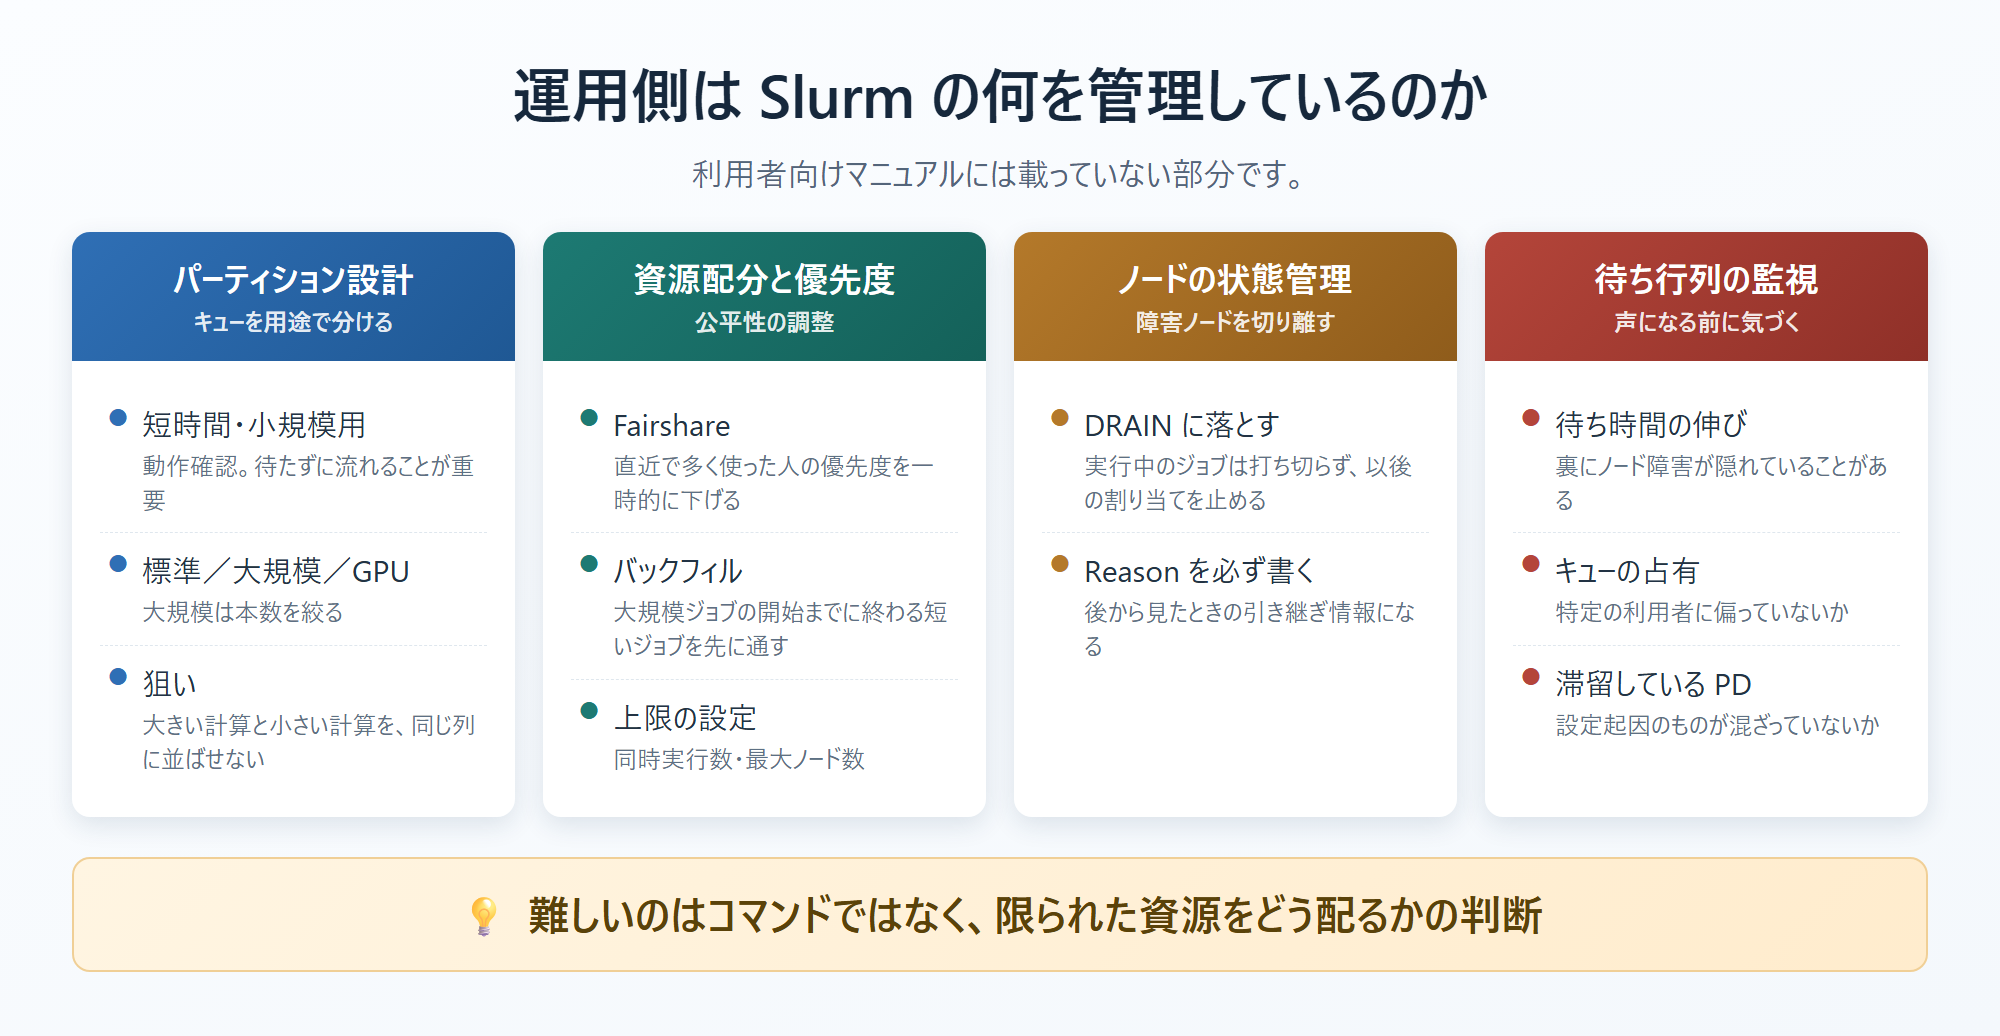
パーティション設計
用途ごとにキューを分け、それぞれに上限を設定します。
- 短時間・小規模用 — 動作確認のためのキュー。待たずにすぐ流れることが重要
- 標準 — 通常の計算。実行時間上限は1日〜数日
- 大規模 — 多ノードを長時間占有する計算。本数を絞る
- GPU — GPU搭載ノード専用
設計の目的は、ひとことで言えば「大きい計算と小さい計算を同じ列に並ばせない」ことです。
大規模ジョブは多数のノードが同時に空くのを待つため、何も制限しないと小さな確認作業がいつまでも割り込めません。逆に小さいジョブばかり通すと、大規模計算が永久に始まりません。短時間用の枠を別に切り、大規模枠は本数を絞ることで両立させます。
資源配分と優先度(QoS)
- 研究室・プロジェクトごとの割り当て量
- 利用実績に応じた優先度の調整(Fairshare)
- 1人あたりの同時実行数・最大ノード数の上限
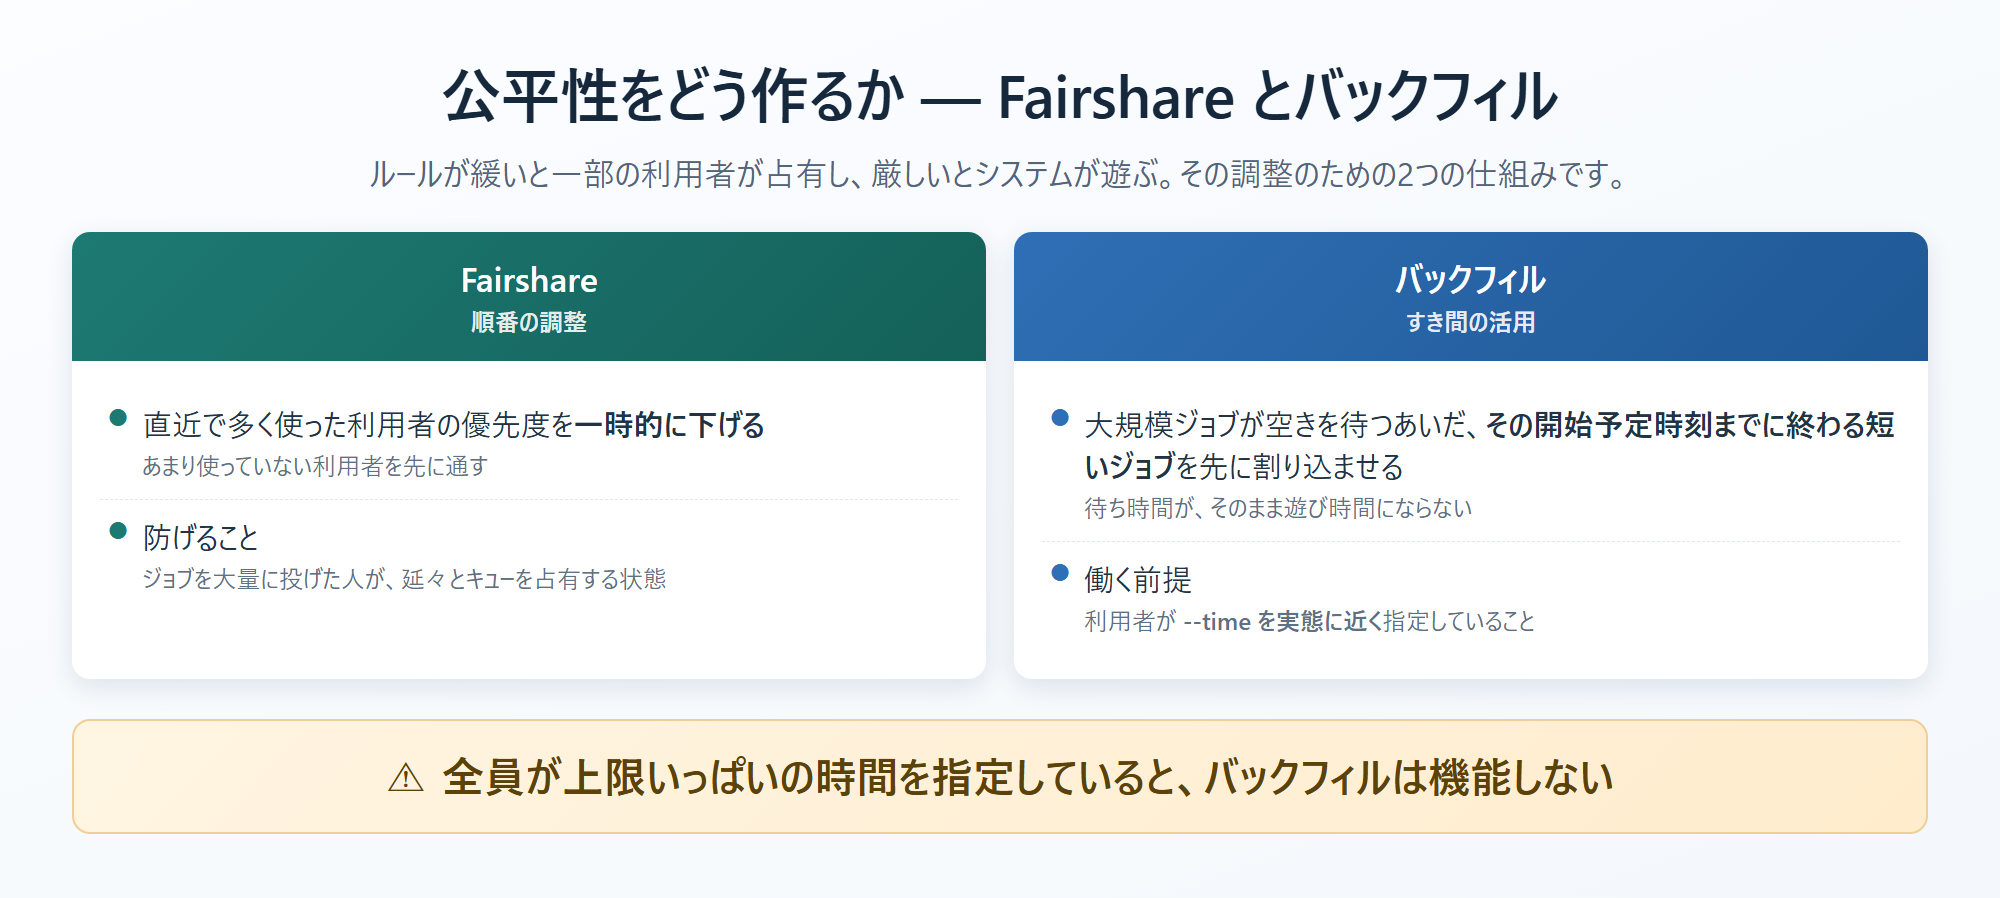
公平性の調整が運用の腕の見せどころです。ルールが緩いと一部の利用者が占有し、厳しいとシステムが遊びます。
よく使われるのが Fairshare の考え方です。直近で多く使った利用者の優先度を一時的に下げ、あまり使っていない利用者を先に通す。これにより、ジョブを大量に投げた人が延々とキューを占有する状態を防ぎます。
あわせて、バックフィルという仕組みも効きます。大規模ジョブが空きを待っているあいだ、その開始予定時刻までに終わる短いジョブを先に割り込ませる機能です。これが働くためには、利用者が --time を実態に近く指定していることが前提になります。全員が上限いっぱいの時間を指定していると、バックフィルは機能しません。
ノードの状態管理
$ scontrol update NodeName=node042 State=DRAIN Reason="memory error 2026-11-13"
ハードウェア障害を検知したノードを、新規のジョブ割り当てから外します。DRAIN は実行中のジョブを打ち切らず、終わり次第それ以上割り当てなくなる状態です。
Reason は必ず書きます。これが後から見たときの引き継ぎ情報になります。
待ち行列の監視
- 待ち時間が異常に伸びていないか
- 特定の利用者がキューを占有していないか
PDのまま滞留しているジョブに、設定起因のものがないか
「待ち時間が長い」という利用者からの声の裏に、ノード障害が隠れていることがあります。 sinfo で down や drain のノード数を見れば、すぐ判断できます。
よくある質問
Slurmは覚えるのが大変ですか?
基本コマンドは5つだけです。考え方も「資源を要求して順番を待つ」というキューイングシステムそのもので、特殊なものではありません。
実務で難しいのは、コマンドの暗記ではなくパーティション設計と資源配分の判断です。これは現場で経験を積む部分なので、入ってから身につけるもので構いません。
未経験でもHPCの運用に入れますか?
Slurmの知識は、入ってから習得できる部類です。採用側が見るのは、Linuxの運用経験とログから原因を切り分ける力です。ジョブスケジューラはその上に乗る1つのミドルウェアにすぎません。
HPCエンジニアに求められるスキルの全体像は、HPCエンジニアの仕事内容|インフラ運用と何が違うのか で整理しています。
手元で練習できますか?
できます。Slurm はオープンソースで、1台のLinuxマシンに入れて擬似的なクラスタとして動かせます。仮想マシン2〜3台でも構成できるので、sbatch と squeue の挙動を確かめるには十分です。
まとめ
- 計算クラスタでは、ログインノードで直接実行せず、ジョブとして投入する
- 押さえるコマンドは
sinfosbatchsqueuescancelsacctの5つ - ジョブスクリプトは、シェルスクリプトの先頭に
#SBATCHを足したもの --timeは長すぎても短すぎても損をする。実測+余裕が最適- ジョブが流れないときは
squeueの(REASON)を見る - 運用側の仕事は、パーティション設計・資源配分・ノード状態の管理・待ち行列の監視
Slurm の操作そのものは難しくありません。難しいのは、限られた計算資源を多数の利用者にどう配るかという判断で、そこはLinux運用で培った感覚がそのまま効く領域です。
参考にした情報
- Slurm の基本コマンド(sbatch でジョブ投入、squeue で状態確認、sinfo でパーティションと制限の一覧)、
#SBATCHによる資源要求、--timeの指定、複数プロジェクト所属時の-A/--account— 理化学研究所 R-CCS Slurmドキュメント / Lawrence Berkeley National Laboratory Slurm Overview / North Carolina State University HPC Running Jobs with Slurm - ログインノードから計算ノードへジョブを投入する構成 — OIST Slurm利用ガイド / DDBJ Slurmの使い方
パーティション名・実行時間の上限・利用可能なモジュールは、センターごとに異なります。記事中の出力例は一般的な例です。
この記事について
この記事は、株式会社計算科学 高度情報人材支援センター(CATIP)HPCエンジニアチームが執筆・監修しています。執筆体制と記事作成のポリシーは 執筆・監修者について をご覧ください。
Linux/UNIX の運用経験を、在宅で活かしませんか
この記事を公開している CATIP(高度情報人材支援センター) では、Linux/UNIXサーバの運用管理のご経験がある方に、お仕事をご紹介しています。
全国どこからでも在宅で、勤務する曜日も時間もご自身で選べます。
- フルリモート(全国47都道府県から応募できます)
- 勤務日・勤務時間は自由選択。土日祝はお休み
- 時給 3,000円〜
- 直接雇用契約と業務委託契約を選べます(派遣ではありません)
- 50代・60代の方、ブランクのある方も歓迎しています
「もう現場から離れている」「フルタイムは難しい」という方こそ、一度ご覧ください。オファー時に仕事の内容をご提示したうえで、受けるかどうかを選んでいただけます。受けない場合の不利益はありません。